Del 13 de mayo al 16 de noviembre de 2026, un trabajo programado en este sitio hizo las mismas 15 preguntas a ChatGPT y Perplexity cada semana. Preguntas de compradores, principalmente: el tipo de preguntas que hace la gente antes de contratar a un desarrollador o dejar WordPress. El trabajo almacenó cada respuesta y cada fuente que citó cada motor. El total llegó a 1,769 respuestas y 9,746 citas.
La mayoría de los escritos sobre citas de LLM son capturas de pantalla de una persona o un estudio de un vendedor diseñado para vender un rastreador. Yo no vendo uno. Así que esta es la versión cruda: lo que los dos motores citaron, con qué frecuencia citaron este sitio, qué cambió en seis meses y qué haría diferente. Se suponía que Gemini sería el tercer motor. Se rompió el 1 de junio, y ese fallo tiene su propia sección abajo.
La versión corta
- Perplexity citó fuentes en el 99.9% de sus respuestas, alrededor de 10 por respuesta, de 694 dominios diferentes.
- ChatGPT citó fuentes en el 34.6% de sus respuestas. La búsqueda en la web estaba activada en cada llamada, pero buscó cada semana durante cinco indicaciones y nunca una sola vez para las otras diez. Los cinco comenzaban con "Best".
- Este sitio fue citado en el 14.4% de las respuestas de Perplexity (125 de 868) y en 2 de 901 respuestas de ChatGPT.
- Seis indicaciones produjeron cada una de esas citas de Perplexity. Cada una tenía una página en este sitio que responde exactamente esa pregunta. Nueve indicaciones nunca citaron el sitio una sola vez en 26 semanas, incluidas tres indicaciones de Londres, a pesar de las páginas de Londres de este sitio.
- Las fuentes apenas se movieron dentro de una ejecución y se desplazaron de semana a semana. Tres copias de una indicación hecha dentro de dos minutos compartían el 86% de sus dominios citados. Una semana después, la superposición era del 47%. Comparando la primera semana con la última, fue del 9%.
- YouTube y Reddit fueron citados en el 32.5% y 29.8% de las respuestas de Perplexity. Clutch fue citado en el 15.2%.
- El rastreador completo costó $24.10 en tarifas de API durante seis meses, incluidas las respuestas vacías de Gemini.
Cómo se recopilaron los datos
El rastreador es una función programada de Netlify que llama a la API de Optimización de IA de DataForSEO una vez a la semana. Cada indicación va a cada motor dos o tres veces por ejecución. El texto de respuesta, las URLs citadas y la posición de este sitio entre ellas se guardan en una tabla de Supabase, y el panel de control del administrador lee de esa misma tabla.
Tres cosas sobre el método son importantes para leer los números:
- Estas son respuestas de API, no las aplicaciones de consumidor. DataForSEO devolvió respuestas de GPT-4o mini para ChatGPT y de Sonar para Perplexity. La aplicación de ChatGPT que usas en un navegador ejecuta modelos diferentes, y sus respuestas serán diferentes. Trata los hallazgos de ChatGPT como "lo que hizo el modelo de API". Los rastreadores basados en API muestrean lo mismo; algunas herramientas comerciales rasguñan las aplicaciones en su lugar.
- Quince indicaciones es un conjunto pequeño. Se eligieron para coincidir con el trabajo que este sitio vende: migración de WordPress, Next.js, Claude Code, SEO técnico en Londres. Están escritas de la manera en que un comprador las escribiría, no de la manera en que una herramienta de palabras clave las enumera. Una decimosexta indicación preguntaba "¿Quién es Gautam Khorana?". Se reporta por separado porque una pregunta de marca te dice poco sobre el sitio de nadie más.
- Un día de ejecución es una muestra del estado de ánimo del motor. Hay 27 días de ejecución en el período. Una brecha a principios de septiembre vino de que el saldo de DataForSEO se agotó, por lo que septiembre tiene dos ejecuciones.
Todo lo siguiente excluye la indicación de marca a menos que diga lo contrario. Dos indicaciones más antiguas también están excluidas, porque no estaban relacionadas con los servicios de este sitio.
Hallazgo 1: Perplexity siempre muestra sus fuentes, ChatGPT principalmente no
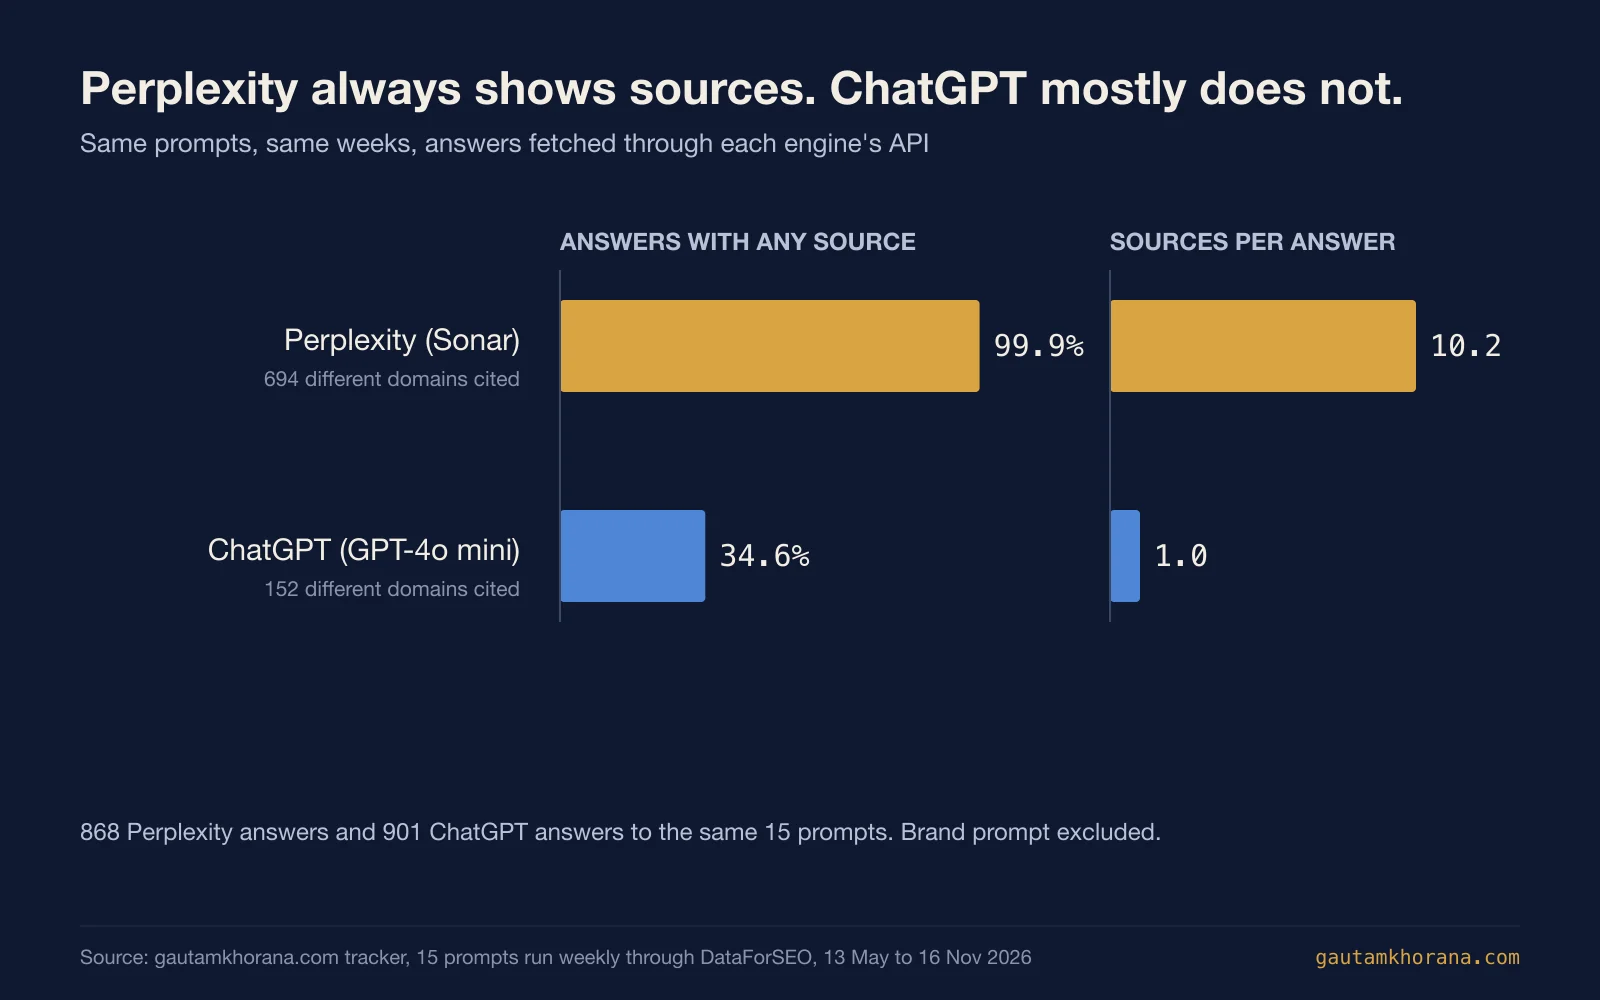
Perplexity respondió las 15 indicaciones con fuentes, 867 veces de 868. La respuesta promedio citó 10.2 fuentes, y en seis meses citó 694 dominios diferentes. Si quieres saber en qué sitios confía un motor de respuestas para tu tema, Perplexity te lo dice cada vez.
ChatGPT, a través de la API, se comportó de manera muy diferente. Solo 312 de sus 901 respuestas vinieron con alguna fuente, y las que lo hicieron llevaban alrededor de tres cada una.
Cada llamada tenía la búsqueda web activada, así que el modelo elegía cuándo usarla. La división no era aleatoria. Era todo o nada, decidido por el prompt.
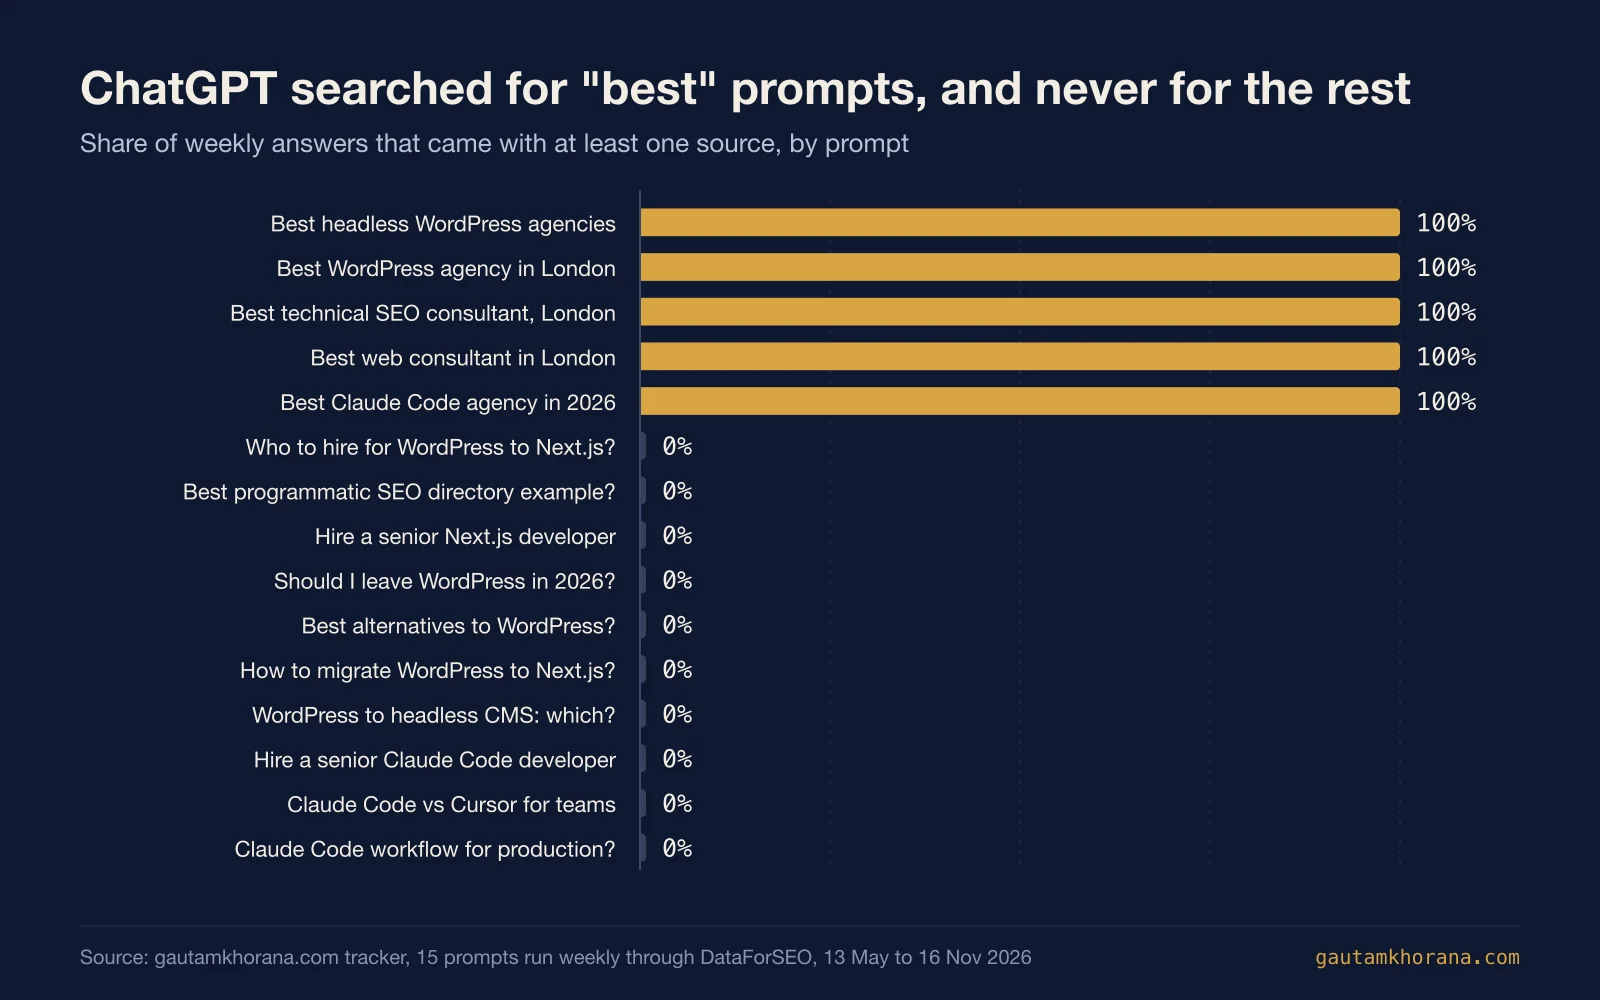
Cada prompt que comenzaba con "Best" obtenía una búsqueda web en cada ejecución: best headless WordPress agencies, best WordPress agency in London, best technical SEO consultant in London, best web consultant in London, best Claude Code agency. El prompt de marca también. Los otros diez nunca la obtenían. Eso incluía "Who should I hire for WordPress to Next.js migration?" e "Hire a senior Claude Code developer", que son tan comerciales como puede serlo un prompt. GPT-4o mini respondía esos basándose en lo que ya sabía, sin fuentes y sin forma de que una página nueva entrara.
Este es el hallazgo más útil del conjunto de datos: no puedes ser citado donde el modelo no busca. Si los prompts que te importan se responden a partir de datos de entrenamiento, una página mejor no cambiará la respuesta este mes. Lo que la cambia es ser mencionado lo suficientemente amplio como para estar en los datos de entrenamiento, o que el modelo decida buscar. La documentación del rastreador de OpenAI es clara en que OAI-SearchBot es lo que te pone en los resultados de búsqueda que ChatGPT puede citar, así que bloquearlo te excluye incluso de los prompts que sí buscan.
Cuando ChatGPT buscó un prompt de Londres, entre una cuarta y un tercio de sus "fuentes" eran enlaces de Google Maps a las agencias que nombró. google.com apareció en el 18.5% de todas las respuestas de ChatGPT, y cada uno de esos enlaces era una búsqueda de Google Maps por nombre de agencia. Para prompts de servicio local, la cita que ChatGPT quiere aquí es un listado de negocio, no una publicación de blog.
Hallazgo 2: una página por pregunta ganó las citas
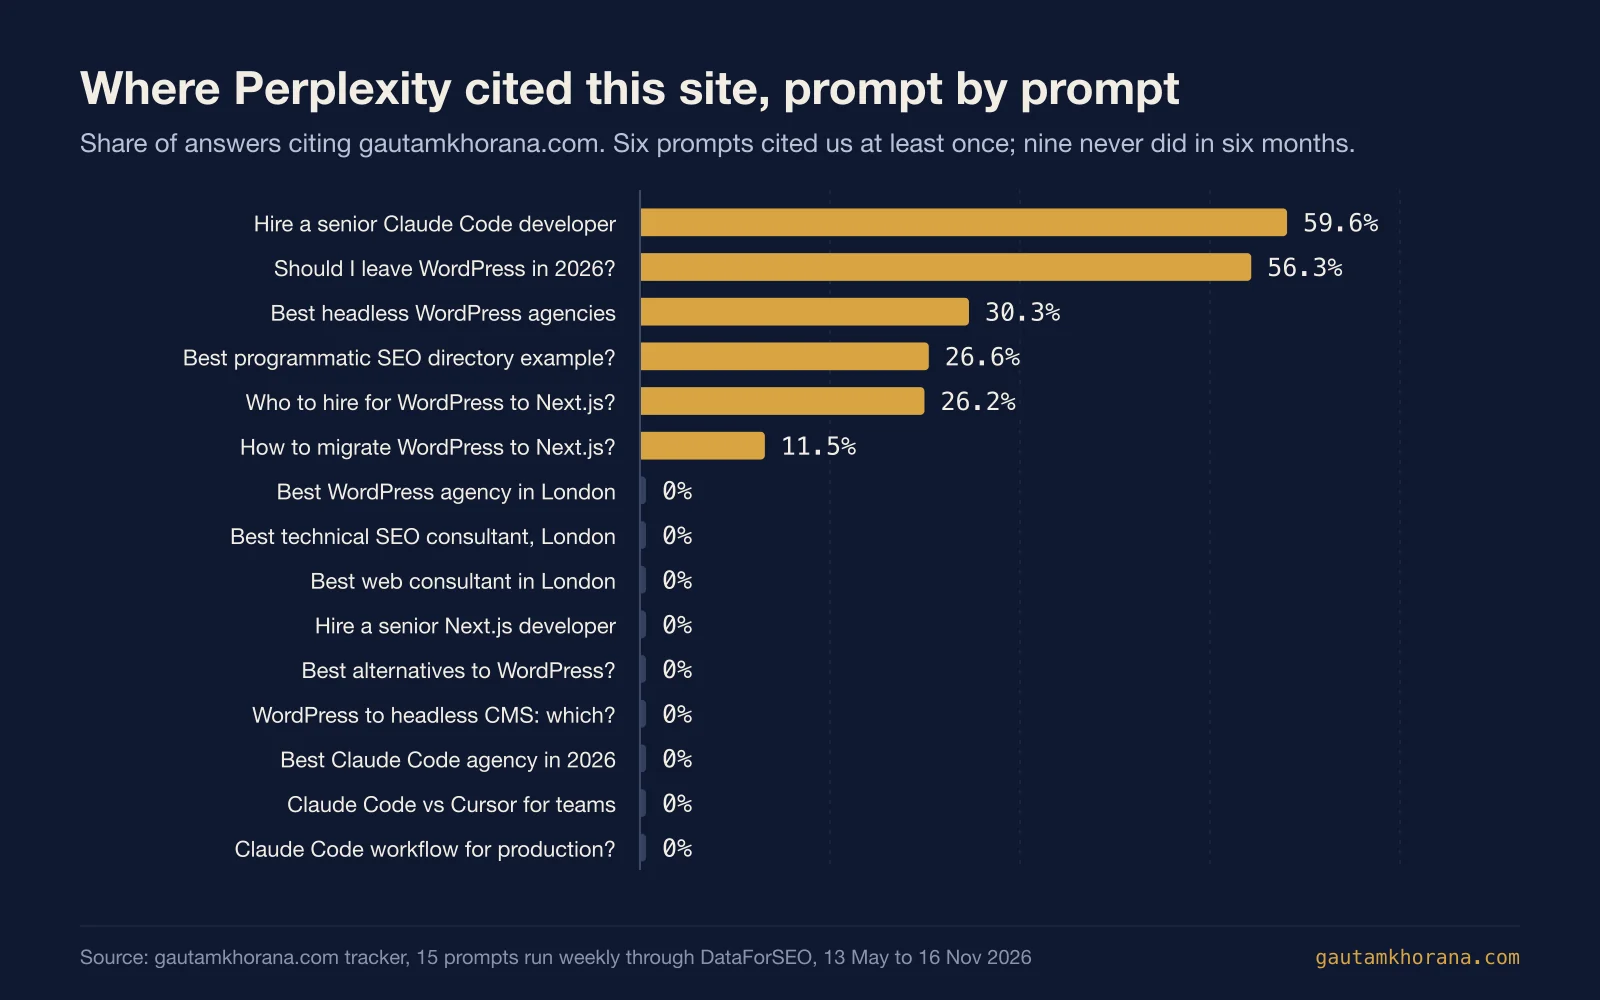
En Perplexity, seis prompts citaron este sitio y nueve nunca lo hicieron. Los seis comparten un rasgo obvio: una página aquí respondía esa pregunta casi palabra por palabra.
| Prompt | Citado en | Página que Perplexity citó más |
|---|---|---|
| Contratar a un desarrollador senior de Claude Code | 59.6% | /hire-claude-code-developer/ |
| ¿Debería abandonar WordPress en 2026? | 56.3% | /leave-wordpress/ |
| Mejores agencias WordPress headless | 30.3% | /best-headless-wordpress-agencies-london/ |
| ¿Cuál es el mejor ejemplo de directorio de SEO programático? | 26.6% | a 2026 programmatic SEO directory post |
| ¿A quién debería contratar para una migración de WordPress a Next.js? | 26.2% | /wordpress-to-nextjs-migration/ |
| ¿Cómo migro de WordPress a Next.js? | 11.5% | /wordpress-to-nextjs-migration/ |
Cinco URLs representan 117 de las 125 citas. Cuando el sitio fue citado, generalmente fue cerca del inicio: la posición mediana fue tercera entre aproximadamente diez fuentes.
Los nueve fracasos son igual de reveladores. "What are the best alternatives to WordPress?" fue a Zapier, Tooltester, Hygraph y Webstudio, que publican listas largas y actualizadas regularmente sobre exactamente esa pregunta. "Hire a senior Next.js developer" fue a mercados de contratación: Arc, ZipRecruiter, Toptal e Indeed. "Best Claude Code agency in 2026" fue a agencias que publican sus propias listas de "best Claude Code agencies".
Los prompts de Londres dolieron más, porque este sitio tiene varias páginas de Londres. En 26 semanas, Perplexity nunca las citó para "best web consultant in London" o "best technical SEO consultant in London". Citó directorios en su lugar: Clutch, DesignRush, Sortlist, Bark, el directorio de agencias de Semrush. También citó los sitios personales de consultores individuales de Londres. Una página que dice "Londres" no es lo mismo que ser uno de los nombres de Londres que esos directorios listan.
Hallazgo 3: la primera cita tomó entre cinco días y diez semanas
Las cinco páginas que ganaron citas estaban en línea el 13 de mayo, cuando comenzó el rastreador. Sus primeras citas llegaron en tiempos muy diferentes:
- /leave-wordpress/ fue citada por primera vez el 18 de mayo, cinco días después.
- /best-headless-wordpress-agencies-london/ fue citada el 25 de mayo.
- /hire-claude-code-developer/, el artículo de SEO programático y /wordpress-to-nextjs-migration/ fueron citadas por primera vez entre el 20 y el 23 de julio, aproximadamente diez semanas después.
Tres páginas citadas en la misma semana podrían ser obra mía o de Perplexity, y no puedo separar completamente las dos cosas. El sitio tuvo una ronda de correcciones de rendimiento, accesibilidad y enlaces internos a mediados de julio. Pero el motor cambió esa misma semana: las respuestas de Perplexity a estas consultas pasaron de 8.8 fuentes en promedio el 13 de julio a 10.0 el 20 de julio, y luego a 17.5 el 3 de agosto.
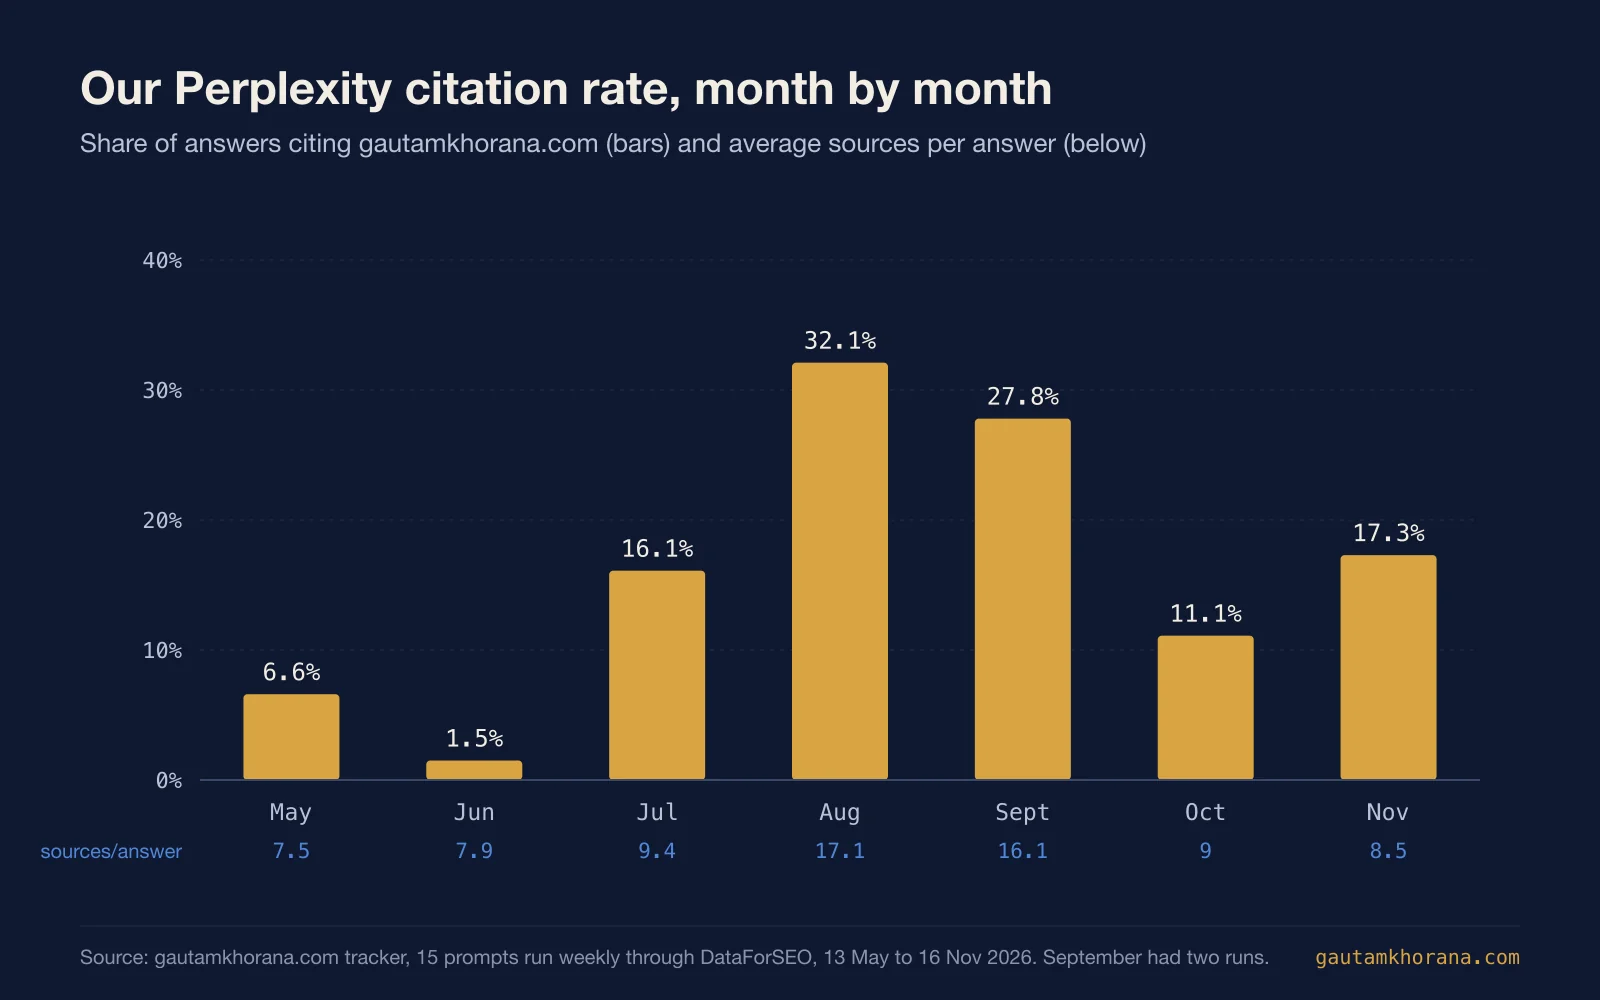
Los números mensuales lo respaldan. En agosto, las respuestas de Perplexity a estas consultas citaron 17.1 fuentes en promedio, frente a 7.9 en junio. La tasa de citas para este sitio pasó de 1.5% a 32.1% en los mismos meses. Luego el promedio bajó a alrededor de 9 en octubre, y la tasa bajó a 11.1%. Más espacios por respuesta significaba más oportunidad para un sitio más pequeño. Parte de lo que se ve como "nuestro trabajo en GEO dando resultado" en un panel es realmente el motor cambiando cuántas fuentes muestra.
Hallazgo 4: las fuentes se mantienen dentro de una ejecución y varían de semana a semana
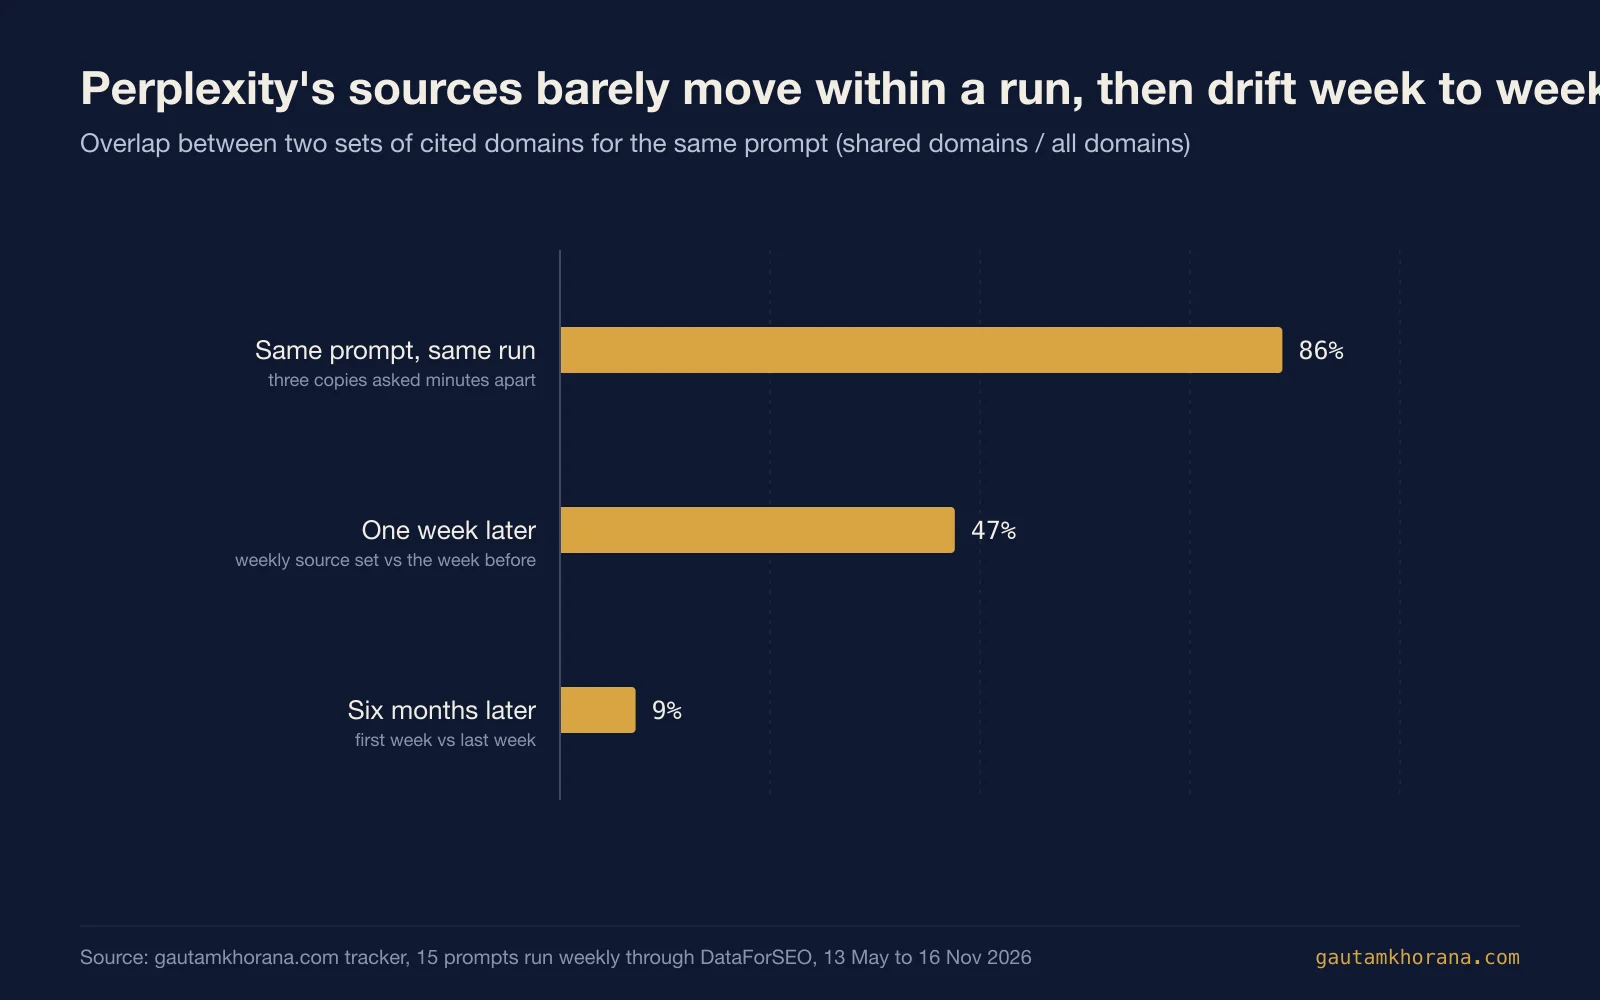
Cada consulta se hizo dos o tres veces por ejecución, dentro de aproximadamente dos minutos. Esas copias coincidieron estrechamente: 86% de sus dominios citados eran compartidos, y en el 98% de las ejecuciones estuvieron de acuerdo sobre si este sitio fue citado o no.
De semana a semana, la coincidencia bajó a 47%. Comparando la primera semana de cada consulta con la última, solo el 9% de los dominios citados sobrevivieron. En seis meses, la lista de fuentes de Perplexity para una pregunta dada fue casi completamente reemplazada.
Esto parece contradecir el estudio de SparkToro y Gumshoe de enero de 2026, que encontró menos de 1 en 100 de probabilidad de que ChatGPT o Google AI proporcionaran la misma lista de marcas dos veces. En realidad no, porque los dos estudios midieron cosas diferentes. Compararon listas de marcas ordenadas escritas por cientos de personas usando las aplicaciones de consumidor. Este compara conjuntos de dominios citados de llamadas API con un minuto de diferencia, que pueden provenir de los mismos resultados de búsqueda. Rand Fishkin señaló exactamente esa pregunta en su estudio: si las llamadas API muestran la misma variedad que ven las personas en las aplicaciones, como sin resolver.
Ambos señalan lo mismo para cualquiera que rastree la visibilidad de IA. Una única verificación te dice muy poco, y una posición de ranking dentro de una respuesta te dice aún menos. Mide la proporción de respuestas que te citan en muchas consultas y muchas semanas: una muestra por semana durante seis meses me dijo mucho más de lo que veinte muestras en una tarde hubieran hecho.
Hallazgo 5: a quién cita Perplexity para preguntas de compradores
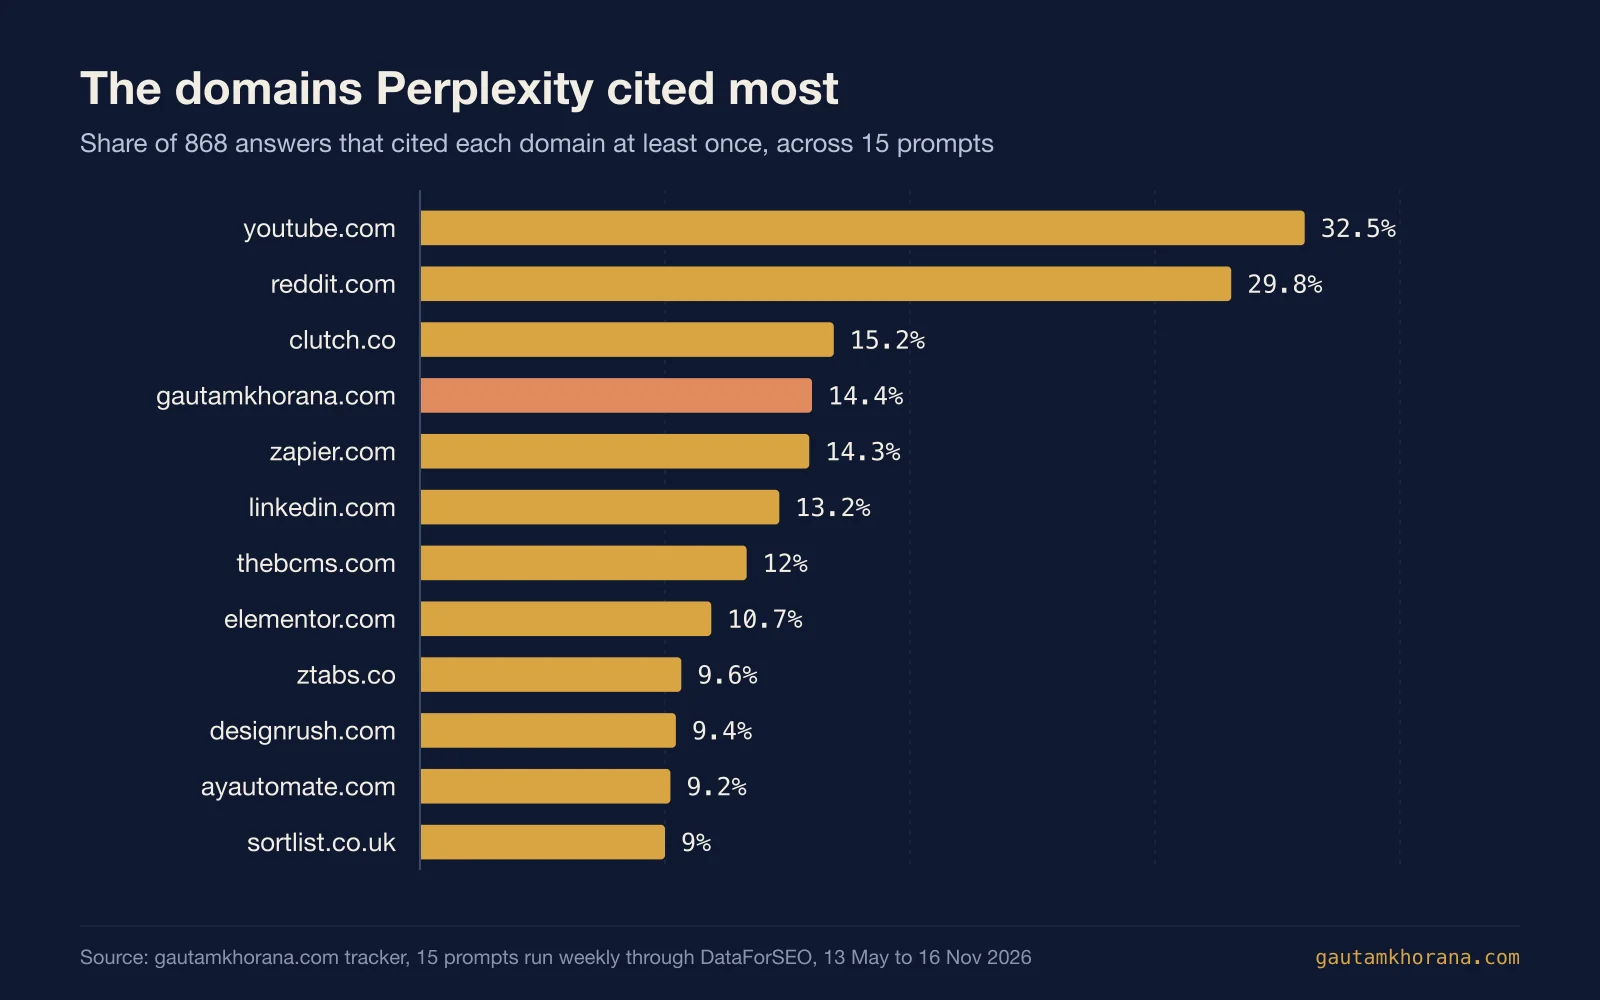
YouTube fue citado en un tercio de todas las respuestas de Perplexity, y Reddit en casi tantas. Ahrefs encontró el mismo patrón en Google: en su estudio de marzo de 2026 de 863,000 páginas de resultados de búsqueda, YouTube fue el dominio más citado, y solo el 38% de las páginas citadas clasificaron en los 10 primeros para la misma consulta.
Desde entonces, he construido esto en un conjunto de datos público más amplio en seo.here, un índice que fundé que rastrea qué firmas recomiendan cinco motores de IA para servicios profesionales, ciudad por ciudad. En todos sus tableros, las fuentes más citadas son Wikipedia y Clutch, cada una en el 11% de las respuestas, luego google.com (9%), Reddit (6%), The Manifest (6%) y GoodFirms (5%). Los directorios y sitios de reseñas también lideran allí.
El resto de la lista se divide en cuatro grupos:
- Directorios y mercados: Clutch, DesignRush, Sortlist, Upwork, Arc, ZipRecruiter, Toptal e Indeed. Ganaron las consultas "best" e "hire".
- Blogs de proveedores: Zapier, BCMS, Elementor, Hygraph y Strapi. Ganaron las consultas "alternatives" y "which CMS" con artículos de comparación largos.
- Agencias que publican listas: varias agencias fueron citadas fuertemente para consultas "best agency", a menudo en listas que ellas mismas escribieron.
- Páginas de una sola pregunta: las cinco páginas de este sitio y algunos sitios personales de consultores.
La lectura práctica es simple. Para cualquier pregunta de comprador tienes tres opciones. Ser la respuesta: una página que la contesta directamente. Estar en la respuesta: listado en los directorios e hilos que el motor ya cita. O estar ausente. La mayor parte del trabajo en SEO para LLM es decidir cuál de las primeras dos opciones perseguir para cada consulta.
Cuánto costó, y el fracaso de Gemini
El rastreador gastó $24.10 en tarifas de DataForSEO en los tres motores. Una respuesta de Perplexity costó aproximadamente $0.006, y una respuesta de ChatGPT costó aproximadamente $0.01. Para comparación, los planes de entrada de las herramientas de visibilidad de IA dedicadas que he visto oscilan entre $20 y $95 al mes. Esas herramientas hacen más que responder esta pregunta estrecha: proporcionan paneles, cubren muchas más consultas y motores, y muestrean las aplicaciones de consumidor. Pero si tu pregunta es "¿estos motores nos citan para estas 15 preguntas?", una API y una tabla de base de datos la responden por unos pocos dólares al mes.
Ahora viene la parte de la que menos estoy orgulloso. Gemini fue el tercer motor, y desde el 1 de junio cada llamada a Gemini falló. DataForSEO dejó de aceptar el nombre de modelo que el rastreador enviaba, gemini-2.0-flash, y respondió cada llamada con un error a nivel de tarea, "Invalid Field: 'model_name'", dentro de una respuesta HTTP exitosa. Mi función detectó el error de tarea. Luego guardó la respuesta vacía como una ejecución normal. Eso sumó 996 respuestas vacías marcadas como exitosas. Durante cinco meses, el panel mostró a Gemini como "nos cita rara vez" cuando Gemini no respondía en absoluto. La columna de costo almacenado también fue incorrecta: leyó el costo del nivel equivocado de la respuesta, así que la cifra real de arriba proviene de las respuestas API sin procesar.
Si construyes tu propio rastreador, verifica tres cosas:
- ¿Realmente cada motor devuelve texto de respuesta? Una respuesta vacía que se registra como "no citado" se ve exactamente como un resultado real.
- ¿El modelo que solicitas aún se sirve? Fija un modelo y alerta cuando desaparece.
- ¿Se guarda un error a nivel de tarea como un error? No confíes solo en el estado HTTP, y no conviertas una tarea fallida en una respuesta vacía.
La solución es pequeña: solicita un modelo Gemini actual y registra una tarea fallida como un fracaso. La lección real es que un cero silencioso necesita verificación antes de reportarlo.
Lo que estoy cambiando por esto
- Una página por cada pregunta del comprador que quiero que me citen. 117 de las 125 citas que ganó este sitio vinieron de páginas construidas alrededor de una sola pregunta. La nueva guía de Cómo clasificarse en ChatGPT es la versión larga de eso.
- Listados de directorios para los prompts de Londres. Ninguna página de Londres en este sitio fue citada por un prompt de Londres en seis meses, mientras que Clutch, DesignRush y Sortlist sí lo fueron. Ese trabajo es listados y reseñas, no más páginas.
- Más prompts, la misma cadencia semanal. Quince prompts es suficiente para ver patrones y muy pocos para generalizar. Los próximos prompts cubren herramientas de visibilidad de IA, tema de los próximos posts aquí.
- Gemini de vuelta, con verificaciones. Sus números aparecerán una vez que haya algunos meses de respuestas reales.
Si quieres que el mismo análisis se ejecute en tus propios prompts, eso es parte del trabajo de SEO y GEO de IA que hago. Para una mirada rápida a Google primero, el verificador de citas de IA gratuito prueba si una página aparece en AI Overviews.
FAQ
¿Con qué frecuencia ChatGPT cita fuentes?
En este estudio, GPT-4o mini a través de la API adjuntó fuentes al 34.6% de sus respuestas, con búsqueda web activada en cada llamada. El patrón fue tajante: buscó cada semana para prompts que comenzaban con "Mejor" y nunca para preguntas formuladas como "cómo", "quién debo contratar" o "debería yo". La aplicación de ChatGPT para consumidores usa otros modelos y puede comportarse diferente, así que trata esto como el comportamiento de un modelo.
¿Cuántas fuentes cita Perplexity por respuesta?
El modelo Sonar de Perplexity promedió 10.2 fuentes por respuesta en 868 respuestas. El promedio mensual se movió entre 7.5 y 17.1, alcanzando su pico en agosto de 2026.
¿Cuáles son los sitios web más citados por los motores de búsqueda de IA?
Para estos 15 prompts de comprador, Perplexity citó YouTube en el 32.5% de respuestas, Reddit en el 29.8%, Clutch en el 15.2%, Zapier en el 14.3% y LinkedIn en el 13.2%. Tu tema tendrá sus propios líderes. Verifica cuáles dominios se citan para tus prompts antes de decidir dónde invertir esfuerzo.
¿Cuánto tiempo tarda en ser citado por Perplexity?
Para las páginas aquí, la primera cita llegó entre cinco días y aproximadamente diez semanas después de que comenzó el rastreo. Tres páginas fueron citadas por primera vez la misma semana en julio, cuando Perplexity comenzó a adjuntar más fuentes a cada respuesta. Los cambios en el lado del motor movieron los números tanto como cualquier cosa en el sitio.
¿Son lo suficientemente estables las citas de LLM para rastrearlas?
Dentro de una sola ejecución, sí: copias del mismo prompt compartieron el 86% de sus fuentes. Entre semanas, mucho menos, con una superposición del 47% después de una semana y del 9% después de seis meses. Rastrear la parte de respuestas que te citan en muchos prompts y semanas, no una sola verificación o una posición.