Vom 13. Mai bis 16. November 2026 stellte ein geplanter Job auf dieser Website wöchentlich dieselben 15 Fragen an ChatGPT und Perplexity. Käuferfragen, meistens: die Art von Fragen, die Menschen stellen, bevor sie einen Entwickler einstellen oder WordPress verlassen. Der Job speicherte jede Antwort und jede Quelle, auf die sich jede Engine bezog. Die Summe belief sich auf 1.769 Antworten und 9.746 Zitate.
Die meisten Texte über LLM-Zitate sind entweder Screenshots einer Person oder eine Verkäuferstudie, die zum Verkauf eines Trackers gedacht ist. Ich verkaufe keinen. Dies ist also die Rohversion: worauf sich die beiden Engines bezogen, wie oft sie diese Website zitierten, was sich über sechs Monate änderte, und was ich anders machen würde. Gemini sollte die dritte Engine sein. Es ist am 1. Juni fehlgeschlagen, und dieser Fehler hat weiter unten einen eigenen Abschnitt.
Die Kurzversion
- Perplexity zitierte Quellen in 99,9 % seiner Antworten, etwa 10 pro Antwort, von 694 verschiedenen Domains.
- ChatGPT zitierte Quellen in 34,6 % seiner Antworten. Die Websuche war bei jedem Aufruf aktiviert, suchte aber jede einzelne Woche für fünf Prompts und nie für die anderen zehn. Alle fünf begannen mit „Best".
- Diese Website wurde in 14,4 % der Perplexity-Antworten (125 von 868) und in 2 von 901 ChatGPT-Antworten zitiert.
- Sechs Prompts erzeugten jedes einzelne dieser Perplexity-Zitate. Jeder hatte eine Seite auf dieser Website, die diese genaue Frage beantwortet. Neun Prompts zitierten die Website in 26 Wochen nicht ein einziges Mal, darunter drei London-Prompts, obwohl diese Website London-Seiten hat.
- Quellen bewegten sich kaum während eines Durchlaufs und drifteten von Woche zu Woche. Drei Kopien eines Prompts, das innerhalb von zwei Minuten gestellt wurde, teilten sich 86 % ihrer zitierten Domains. Eine Woche später betrug die Übereinstimmung 47 %. Der Vergleich der ersten Woche mit der letzten betrug 9 %.
- YouTube und Reddit wurden in 32,5 % und 29,8 % der Perplexity-Antworten zitiert. Clutch wurde in 15,2 % zitiert.
- Der gesamte Tracker kostete in sechs Monaten 24,10 US-Dollar an API-Gebühren, einschließlich Geminis leerer Antworten.
Wie die Daten gesammelt wurden
Der Tracker ist eine Netlify-Funktion, die wöchentlich die DataForSEO AI Optimization API aufruft. Jeder Prompt geht bei jedem Durchlauf zwei- oder dreimal an jede Engine. Der Antworttext, die zitierten URLs und die Position dieser Website unter ihnen landen in einer Supabase-Tabelle, und das Admin-Dashboard liest aus derselben Tabelle.
Drei Dinge zur Methode sind wichtig für die Interpretation der Zahlen:
- Dies sind API-Antworten, nicht die Consumer-Apps. DataForSEO gab Antworten von GPT-4o mini für ChatGPT und von Sonar für Perplexity zurück. Die ChatGPT-App, die Sie in einem Browser verwenden, führt verschiedene Modelle aus, und ihre Antworten werden sich unterscheiden. Behandeln Sie die ChatGPT-Ergebnisse als „was das API-Modell tat". API-basierte Tracker nehmen dieselbe Stichprobe; einige kommerzielle Tools kratzen stattdessen die Apps.
- Fünfzehn Prompts sind eine kleine Menge. Sie wurden ausgewählt, um die Arbeit zu entsprechen, die diese Website verkauft: WordPress-Migration, Next.js, Claude Code, technisches SEO in London. Sie sind so geschrieben, wie ein Käufer sie eintippen würde, nicht wie ein Keyword-Tool sie auflistet. Ein sechzehnter Prompt fragte „Who is Gautam Khorana?". Er wird separat berichtet, da eine Markenfrage wenig über die Website eines anderen aussagt.
- Ein Lauftag ist eine Stichprobe der Stimmung der Engine. Es gibt 27 Lauftage im Zeitraum. Eine Lücke im frühen September war auf einen Mangel am DataForSEO-Guthaben zurückzuführen, daher hat September zwei Läufe.
Alles nachfolgend schließt den Brand-Prompt aus, sofern nicht anders angegeben. Zwei ältere Prompts sind auch ausgeschlossen, da sie unabhängig von den Dienstleistungen dieser Website waren.
Erkenntnis 1: Perplexity zeigt seine Quellen immer, ChatGPT meistens nicht
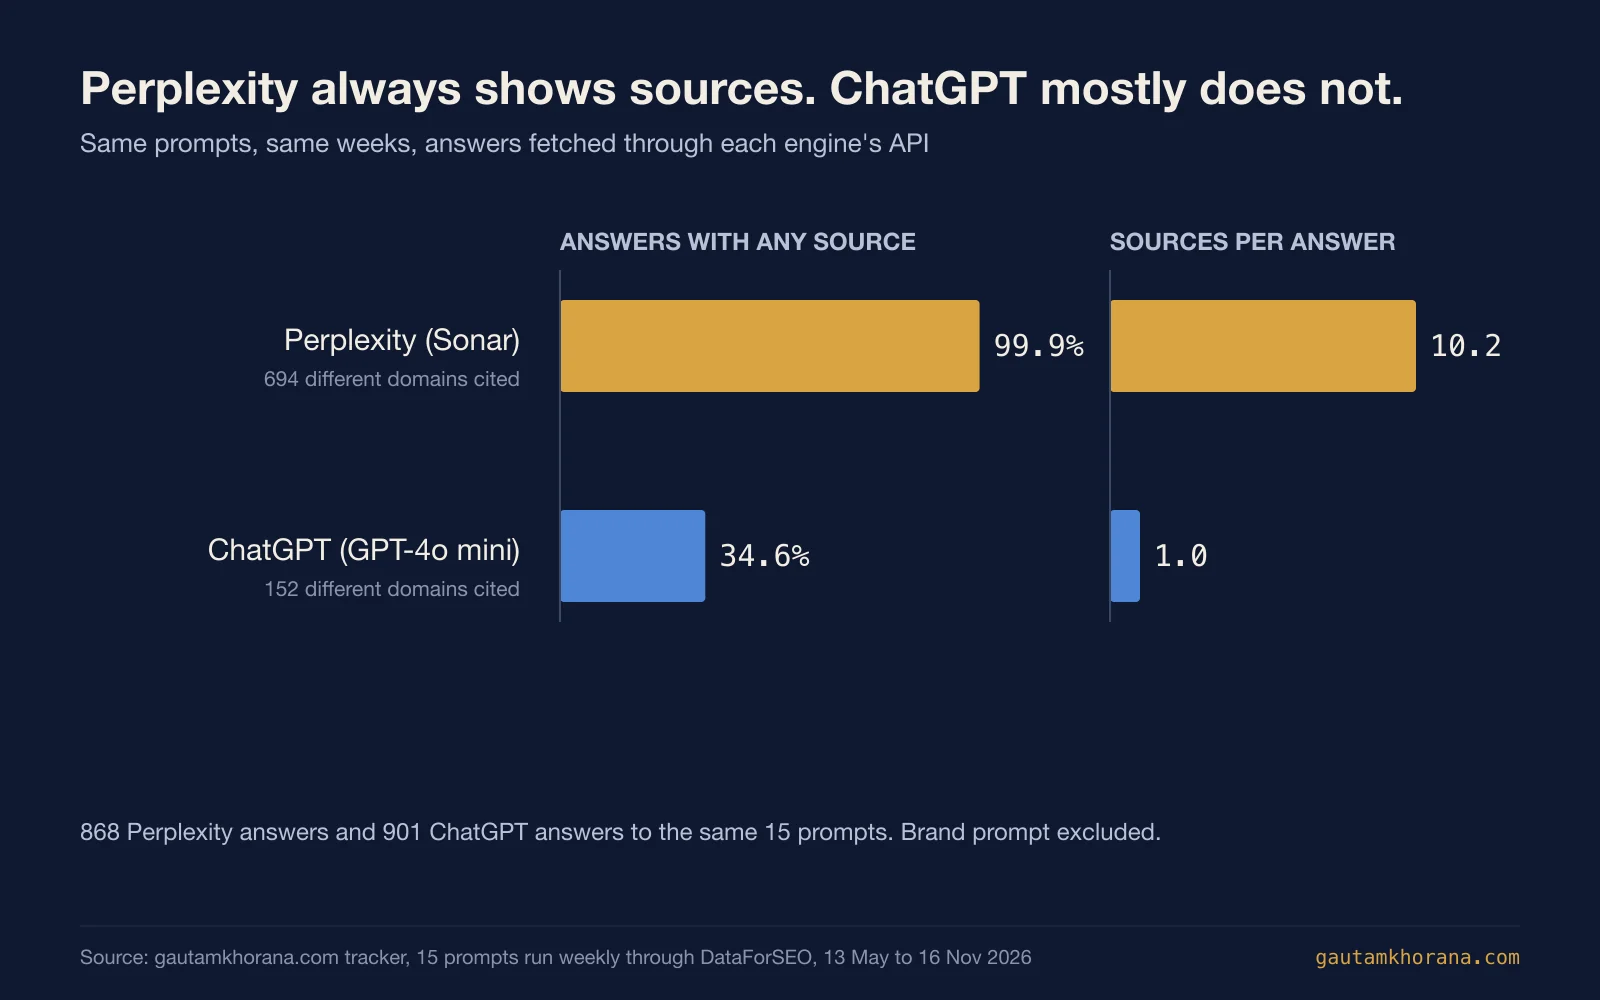
Perplexity beantwortete alle 15 Prompts mit Quellen, 867 Mal von 868. Die durchschnittliche Antwort zitierte 10,2 Quellen, und über sechs Monate zitierte sie 694 verschiedene Domains. Wenn Sie wissen möchten, welche Websites eine Antwort-Engine für Ihr Thema vertraut, sagt Ihnen Perplexity dies jedes Mal.
ChatGPT verhielt sich über die API sehr unterschiedlich. Nur 312 von seinen 901 Antworten kamen mit einer Quelle überhaupt, und diejenigen, die es taten, trugen jeweils etwa drei.
Bei jedem Aufruf war die Websuche aktiviert, das Modell entschied selbst, wann es sie nutzte. Die Aufteilung war nicht zufällig. Es war alles oder nichts, bestimmt durch die Anfrage.
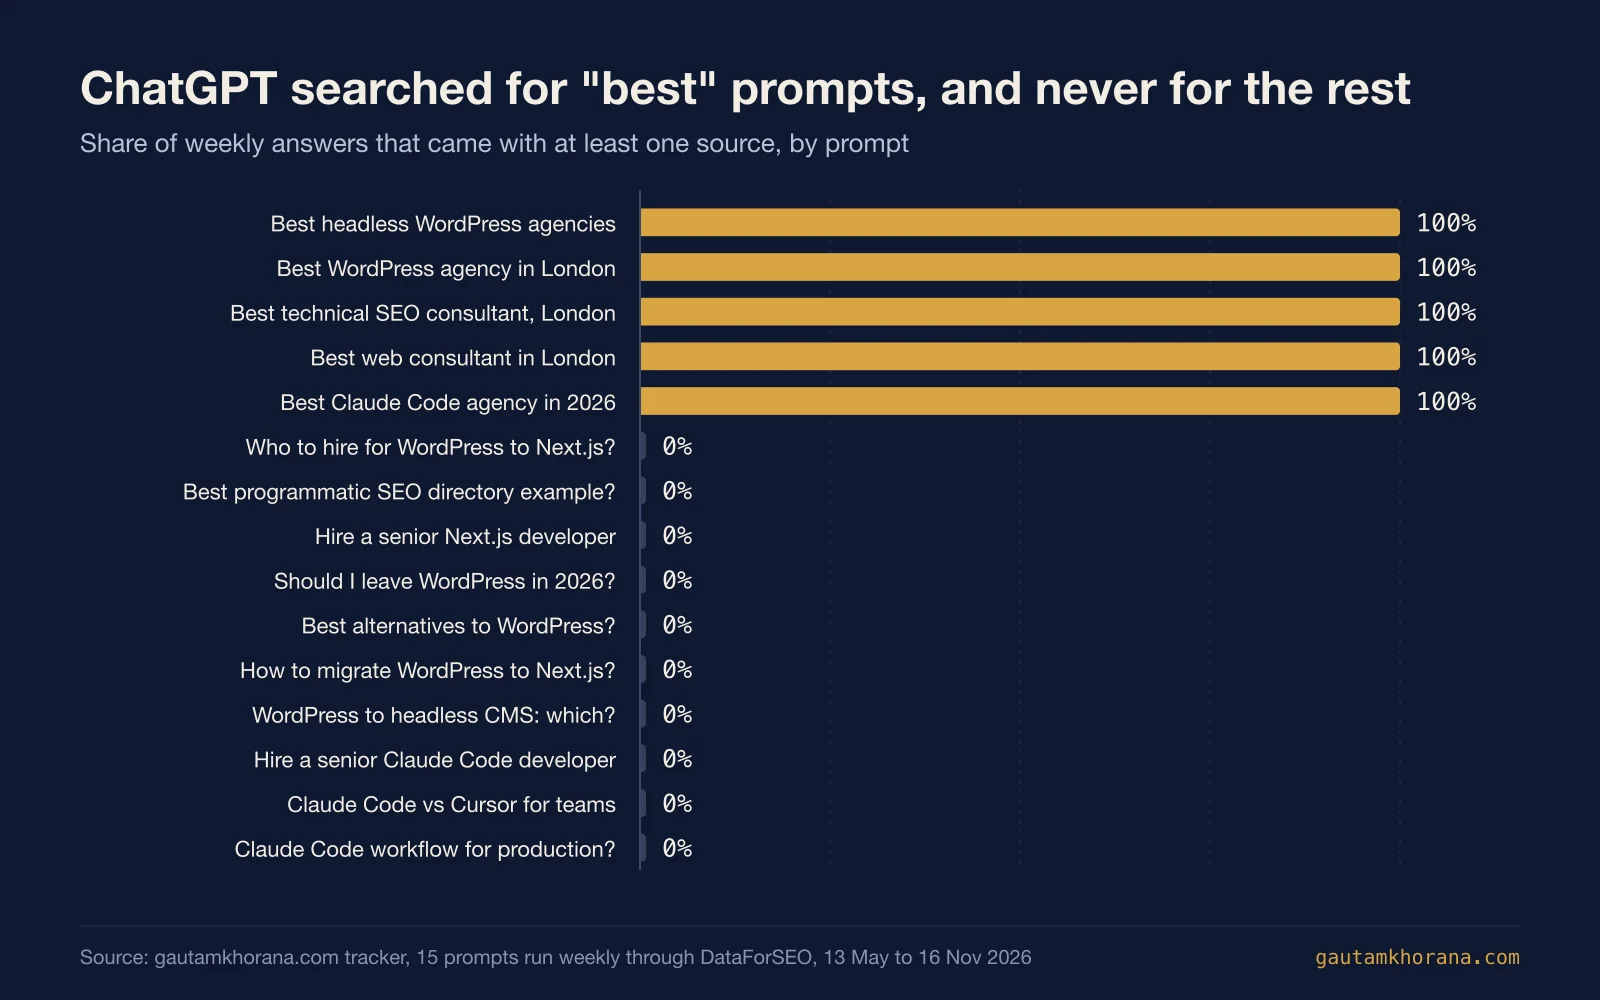
Jeder Prompt, der mit "Best" anfing, bekam eine Websuche bei jedem einzelnen Durchlauf: best headless WordPress agencies, best WordPress agency in London, best technical SEO consultant in London, best web consultant in London, best Claude Code agency. Auch der Brand-Prompt. Die anderen zehn bekamen keine. Das schloss "Who should I hire for WordPress to Next.js migration?" und "Hire a senior Claude Code developer" ein, die sind so kommerziell wie es nur geht. GPT-4o mini beantwortete diese aus seinem bestehenden Wissen, ohne Quellen und ohne Chance für eine neue Seite, aufzutauchen.
Das ist die nützlichste Erkenntnis aus dem Datensatz: Du kannst nicht zitiert werden, wo das Modell nicht sucht. Wenn die Anfragen, die dir wichtig sind, aus Trainingsdaten beantwortet werden, verändert eine bessere Seite diese Antwort diesen Monat nicht. Was es ändert, ist, weit genug erwähnt zu werden, um in den Trainingsdaten zu sein, oder dass das Modell beschließt zu suchen. Die OpenAI-Crawler-Dokumentation macht klar, dass OAI-SearchBot dich in die Suchergebnisse bringt, die ChatGPT zitieren kann, also ihn zu blockieren schließt dich auch aus den Anfragen aus, die suchen.
Als ChatGPT einen London-Prompt durchsuchte, waren zwischen einem Viertel und einem Drittel seiner "Quellen" Google Maps-Links zu den Agenturen, die es nannte. google.com erschien in 18,5% aller ChatGPT-Antworten, und jeder dieser Links war eine Google Maps-Suche nach einem Agenturnamen. Bei lokalen Service-Anfragen ist das Zitat, das ChatGPT hier will, ein Geschäftseintrag, kein Blogpost.
Erkenntnis 2: eine Seite pro Frage gewann die Zitate
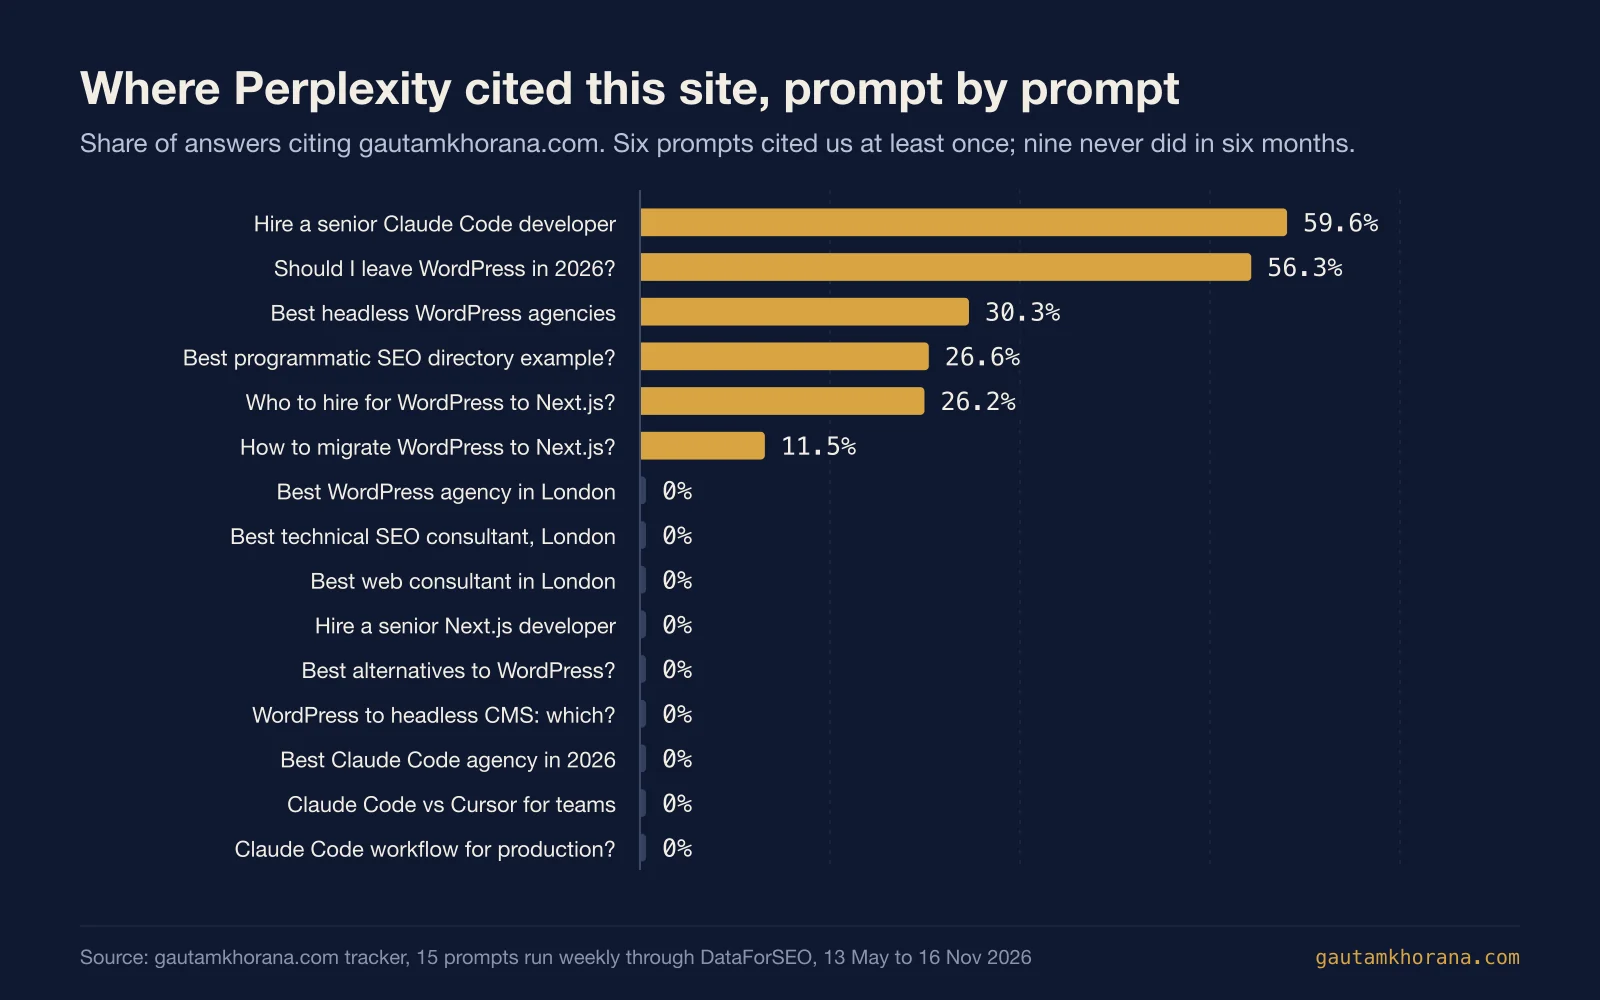
Bei Perplexity zitierten sechs Anfragen diese Seite und neun nie. Die sechs teilen ein offensichtliches Merkmal: eine Seite hier beantwortete diese Frage fast wörtlich.
| Anfrage | Zitiert in | Seite, die Perplexity am häufigsten zitierte |
|---|---|---|
| Senior Claude Code Developer einstellen | 59.6% | /hire-claude-code-developer/ |
| Sollte ich WordPress 2026 aufgeben? | 56.3% | /leave-wordpress/ |
| Best Headless-WordPress-Agenturen | 30.3% | /best-headless-wordpress-agencies-london/ |
| Was ist das beste Beispiel für ein programmatisches SEO-Verzeichnis? | 26.6% | a 2026 programmatic SEO directory post |
| Wen sollte ich für eine Migration von WordPress zu Next.js beauftragen? | 26.2% | /wordpress-to-nextjs-migration/ |
| Wie migriere ich von WordPress zu Next.js? | 11.5% | /wordpress-to-nextjs-migration/ |
Fünf URLs machen 117 der 125 Zitate aus. Wenn die Seite zitiert wurde, war sie normalerweise weit oben: die mittlere Position war dritte unter etwa zehn Quellen.
Die neun Ausfälle sind genauso aussagekräftig. "What are the best alternatives to WordPress?" ging zu Zapier, Tooltester, Hygraph und Webstudio, die lange, regelmäßig aktualisierte Listen genau zu dieser Frage veröffentlichen. "Hire a senior Next.js developer" ging zu Einstellungsmarktplätzen: Arc, ZipRecruiter, Toptal und Indeed. "Best Claude Code agency in 2026" ging zu Agenturen, die ihre eigenen "best Claude Code agencies"-Listen veröffentlichen.
Die London-Anfragen schmerzen am meisten, weil diese Seite mehrere London-Seiten hat. In 26 Wochen zitierte Perplexity sie nie für "best web consultant in London" oder "best technical SEO consultant in London". Es zitierte stattdessen Verzeichnisse: Clutch, DesignRush, Sortlist, Bark, Semrushs Agenturverzeichnis. Es zitierte auch die persönlichen Seiten einzelner Londoner Berater. Eine Seite, die "London" sagt, ist dasselbe nicht wie einer der Londoner Namen in diesen Verzeichnissen zu sein.
Erkenntnis 3: das erste Zitat dauerte zwischen fünf Tagen und zehn Wochen
Alle fünf Seiten, die Zitate gewannen, waren am 13. Mai live, als der Tracker startete. Ihre ersten Zitate kamen zu sehr unterschiedlichen Zeiten an:
- /leave-wordpress/ wurde zuerst am 18. Mai zitiert, fünf Tage später.
- /best-headless-wordpress-agencies-london/ wurde am 25. Mai zitiert.
- /hire-claude-code-developer/, der programmatic-SEO-Post und /wordpress-to-nextjs-migration/ wurden alle erstmals zwischen 20. und 23. Juli zitiert, etwa zehn Wochen später.
Drei Seiten, die in derselben Woche aufgegriffen wurden, könnten von mir oder von Perplexity stammen, und ich kann die beiden nicht vollständig trennen. Die Website hatte Mitte Juli eine Reihe von Verbesserungen bei Leistung, Barrierefreiheit und internen Links. Aber die Engine änderte sich dieselbe Woche: Perplexity's Antworten auf diese Fragen gingen von durchschnittlich 8,8 Quellen am 13. Juli auf 10,0 am 20. Juli, dann auf 17,5 am 3. August.
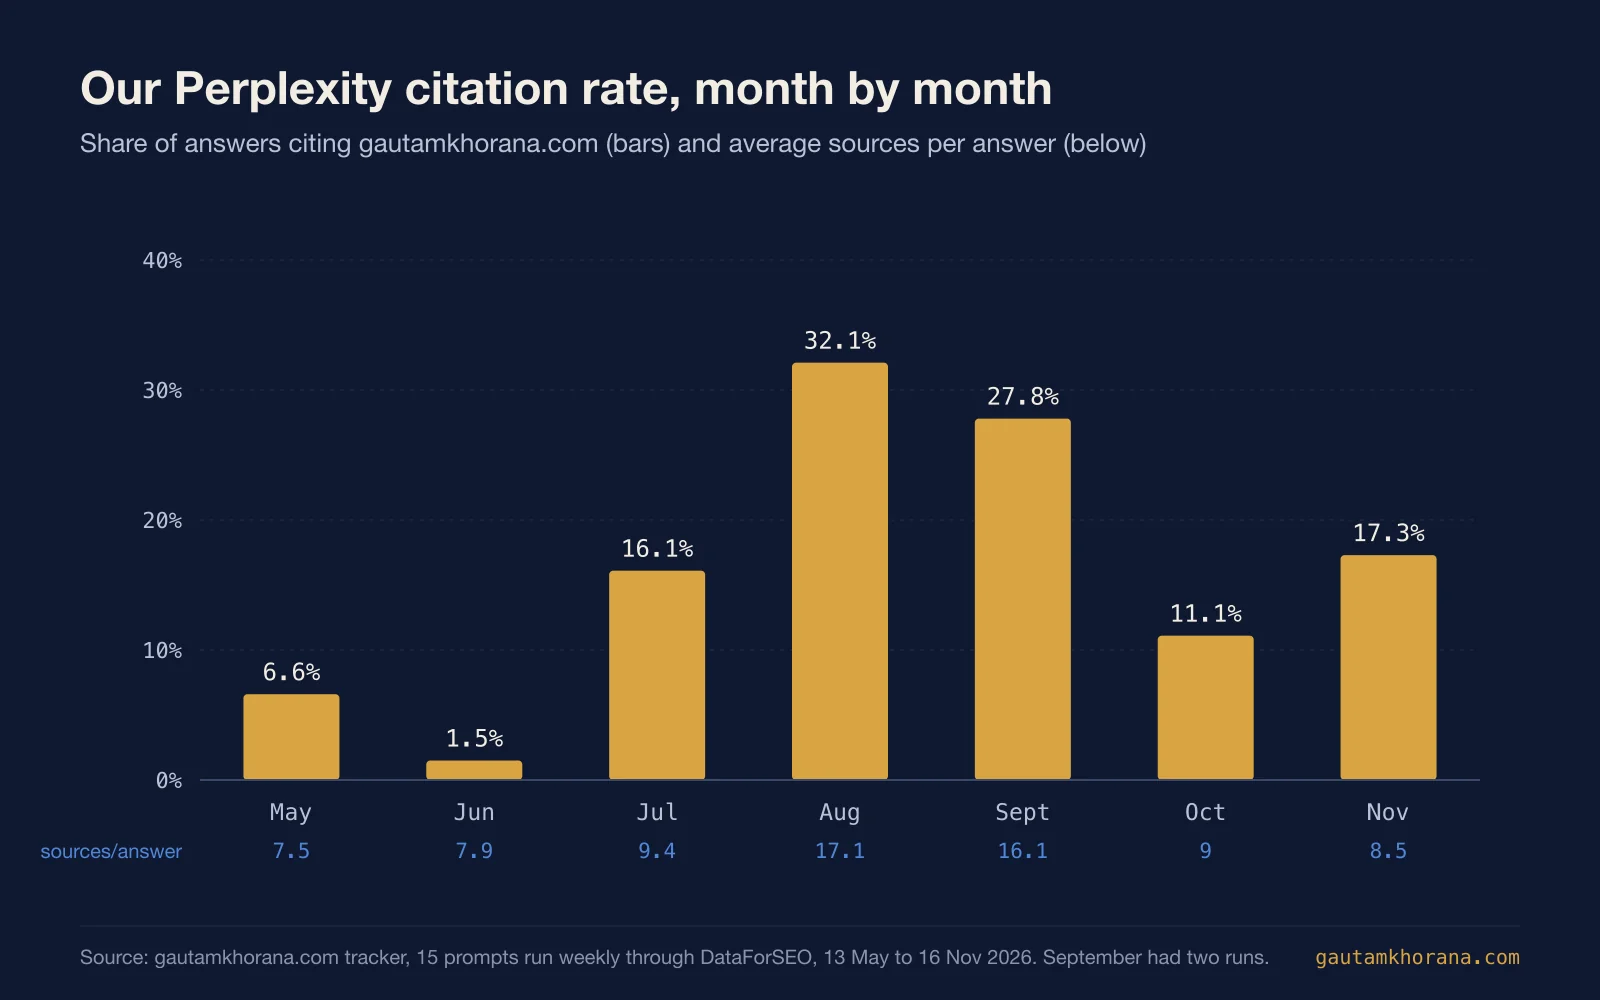
Die monatlichen Zahlen bestätigen das. Im August zitierten Perplexity's Antworten auf diese Fragen durchschnittlich 17,1 Quellen, gegenüber 7,9 im Juni. Die Zitierungsrate für diese Website stieg in denselben Monaten von 1,5 % auf 32,1 %. Dann fiel der Durchschnitt im Oktober auf etwa 9 zurück, und die Rate fiel mit ihm auf 11,1 %. Mehr Plätze pro Antwort bedeuteten mehr Raum für eine kleinere Website. Ein Teil dessen, was in einem Dashboard wie „unsere GEO-Arbeit zahlt sich aus" aussieht, ist wirklich die Engine, die ändert, wie viele Quellen sie anzeigt.
Erkenntnis 4: Quellen halten sich innerhalb eines Durchlaufs und driften wöchentlich
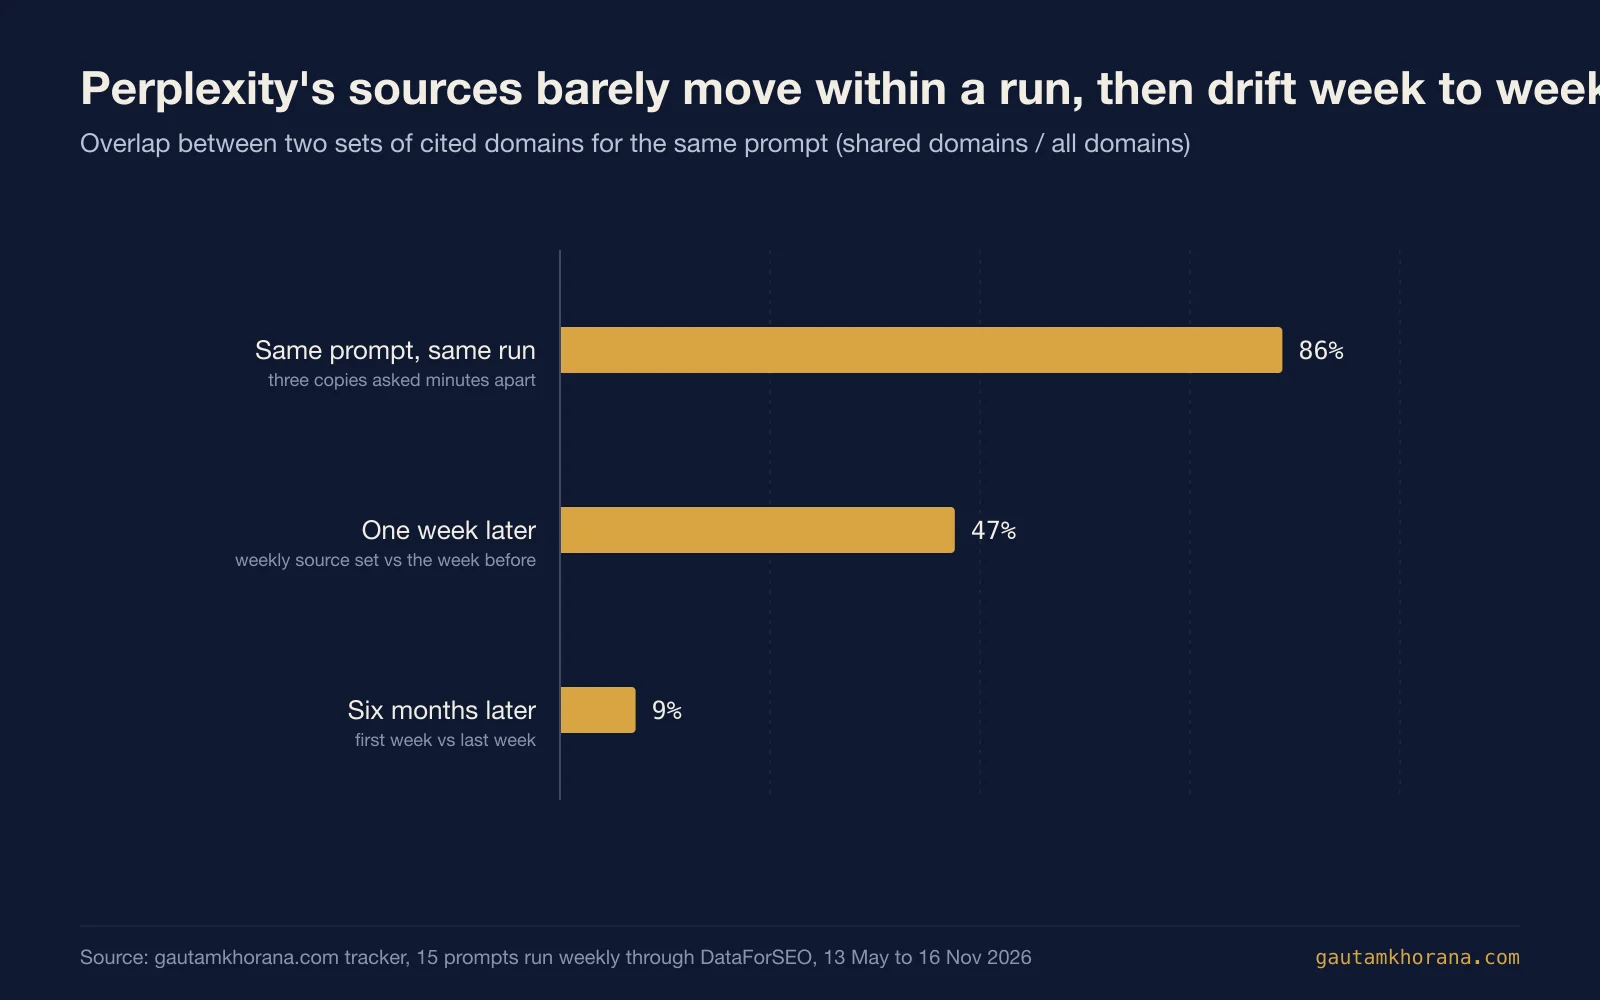
Jede Frage wurde zwei- oder dreimal pro Durchlauf gestellt, innerhalb von etwa zwei Minuten. Diese Kopien stimmten eng überein: 86 % ihrer zitierten Domains waren gemeinsam, und in 98 % der Durchläufe stimmten sie darüber überein, ob diese Website überhaupt zitiert wurde.
Woche für Woche fiel die Überlappung auf 47 %. Beim Vergleich der ersten Woche jeder Frage mit ihrer letzten blieben nur 9 % der zitierten Domains erhalten. Über sechs Monate wurde Perplexity's Quellenliste für eine gegebene Frage fast vollständig ersetzt.
Das sieht so aus, als würde es die Studie von SparkToro und Gumshoe vom Januar 2026 widersprechen, die eine Chance von weniger als 1 zu 100 fand, dass ChatGPT oder Googles KI zweimal die gleiche Markenliste geben. Das tut es nicht wirklich, denn die beiden Studien maßen unterschiedliche Dinge. Sie verglichen geordnete Markenlisten, die von Hunderten von Nutzern der Consumer-Apps geschrieben wurden. Diese vergleicht Mengen von zitierten Domains aus API-Aufrufen, die eine Minute auseinander liegen, die möglicherweise aus denselben Suchergebnissen stammen. Rand Fishkin flaggte genau diese Frage in seiner Studie, ob API-Aufrufe die gleiche Vielfalt zeigen, die Nutzer in den Apps sehen, als ungelöst.
Beide deuten in die gleiche Richtung für alle, die KI-Sichtbarkeit verfolgen. Eine einzelne Überprüfung sagt dir sehr wenig, und eine Ranking-Position in einer Antwort sagt dir noch weniger. Messen Sie den Anteil der Antworten, die Sie über viele Fragen und viele Wochen hinweg zitieren: eine Stichprobe pro Woche über sechs Monate sagte mir weit mehr als zwanzig Stichproben an einem Nachmittag getan hätte.
Erkenntnis 5: wen Perplexity für Käuferfragen zitiert
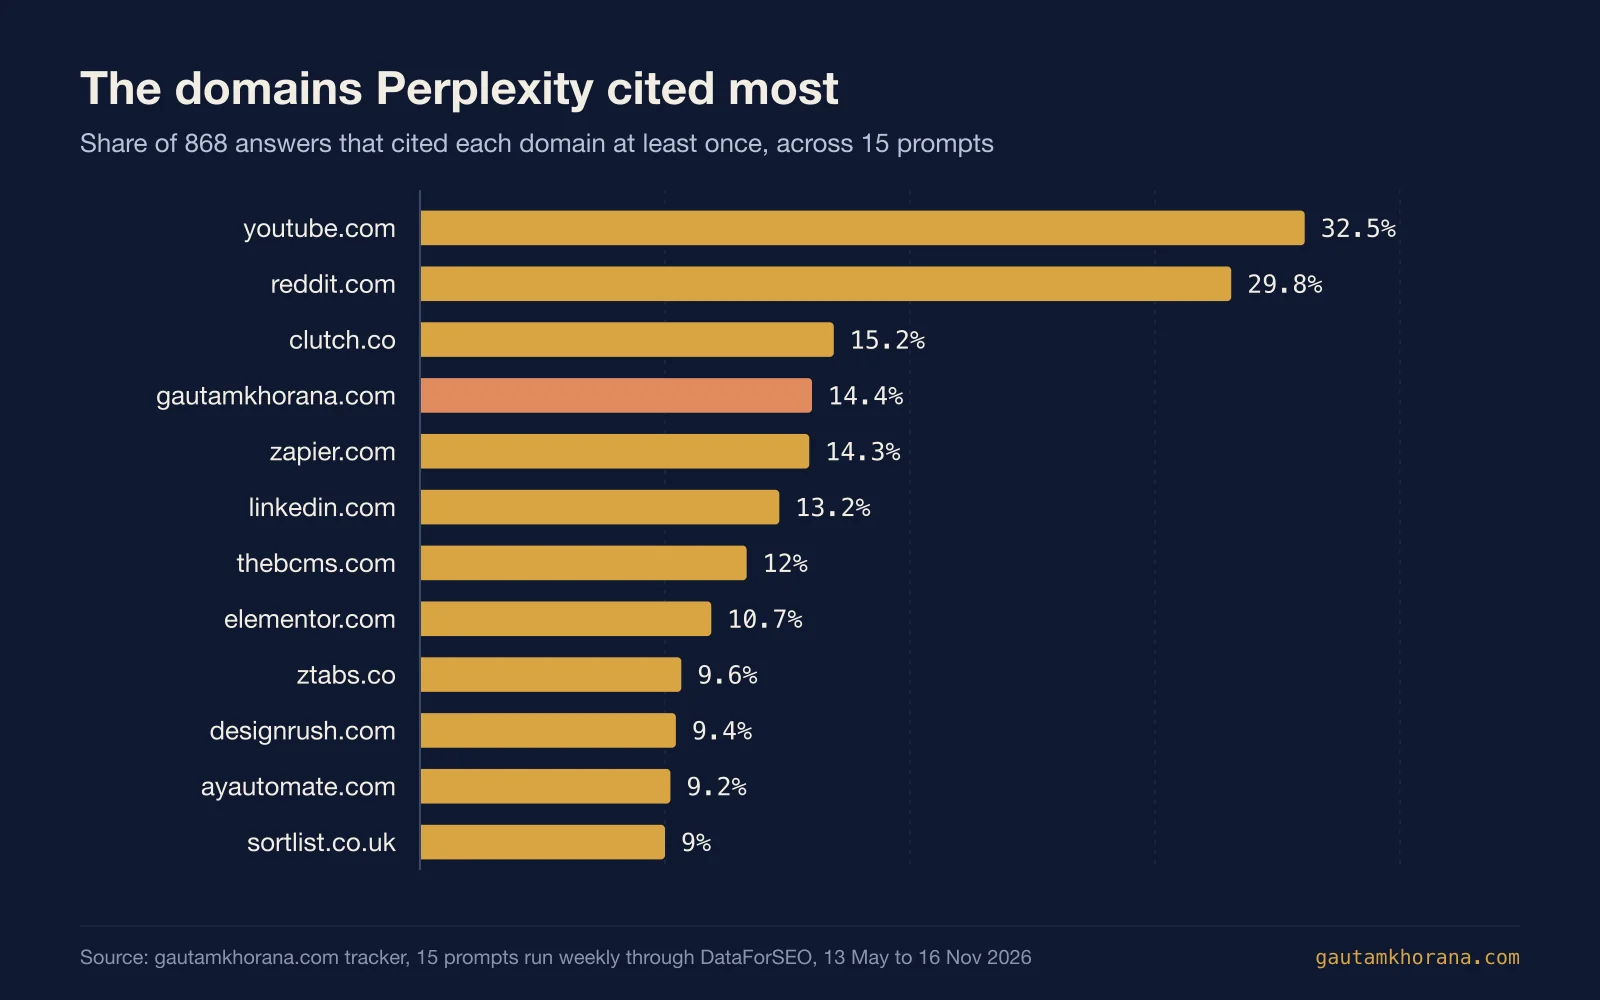
YouTube wurde in einem Drittel aller Perplexity-Antworten zitiert, und Reddit in fast genauso vielen. Ahrefs fand das gleiche Muster in Google: in seiner Studie von März 2026 mit 863.000 Suchergebnisseiten war YouTube die am häufigsten zitierte Domain, und nur 38 % der zitierten Seiten rangierten in den Top 10 für dieselbe Abfrage.
Ich habe das seitdem in einen breiteren öffentlichen Datensatz bei seo.here ausgebaut, einen Index, den ich gegründet habe und der verfolgt, welche Firmen fünf KI-Engines für Professional Services empfehlen, Stadt für Stadt. Über alle seine Boards hinweg sind die meistzitierten Quellen Wikipedia und Clutch, jeweils in 11% der Antworten, dann google.com (9%), Reddit (6%), The Manifest (6%) und GoodFirms (5%). Verzeichnisse und Review-Sites führen auch dorthin.
Der Rest der Liste sortiert sich in vier Gruppen:
- Verzeichnisse und Marktplätze: Clutch, DesignRush, Sortlist, Upwork, Arc, ZipRecruiter, Toptal und Indeed. Sie gewannen die „beste" und „mieten" Fragen.
- Hersteller-Blogs: Zapier, BCMS, Elementor, Hygraph und Strapi. Sie gewannen die „Alternativen" und „welches CMS" Fragen mit langen Vergleichspostern.
- Agenturen, die Listen veröffentlichen: mehrere Agenturen wurden stark für „beste Agentur" Fragen zitiert, oft in Listen, die sie selbst schrieben.
- Seiten mit einer Frage: diese Website's fünf Seiten und einige persönliche Seiten von Beratern.
Die praktische Lesart ist einfach. Für jede Käuferfrage hast du drei Optionen. Sei die Antwort: eine Seite, die sie direkt beantwortet. Sei in der Antwort: aufgelistet auf den Verzeichnissen und Threads, die die Engine bereits zitiert. Oder sei abwesend. Der Großteil der Arbeit in LLM SEO besteht darin, zu entscheiden, welche der ersten beiden man für jede Frage verfolgt.
Was es gekostet hat, und das Gemini-Versagen
Der Tracker gab 24,10 $ an DataForSEO-Gebühren über alle drei Engines aus. Eine Perplexity-Antwort kostete etwa 0,006 $, und eine ChatGPT-Antwort kostete etwa 0,01 $. Zum Vergleich: Die Einstiegspläne der dedizierten AI-Visibility-Tools, die ich mir angesehen habe, liegen zwischen etwa 20 und 95 $ pro Monat. Diese Tools leisten mehr als diese enge Frage zu beantworten: Sie geben Dashboards, decken viel mehr Fragen und Engines ab und probieren die Consumer-Apps aus. Aber wenn deine Frage „zitieren diese Engines uns für diese 15 Fragen?" ist, beantworten eine API und eine Datenbanktabelle das für ein paar Dollar pro Monat.
Jetzt kommt der Teil, auf den ich am wenigsten stolz bin. Gemini war die dritte Engine, und ab 1. Juni schlugen alle Gemini-Aufrufe fehl. DataForSEO akzeptierte den Modellnamen nicht mehr, den der Tracker sendete, gemini-2.0-flash, und antwortete auf jeden Aufruf mit einem Task-Level-Fehler, "Invalid Field: 'model_name'", innerhalb einer erfolgreichen HTTP-Antwort. Meine Funktion erkannte den Task-Fehler. Dann speicherte sie die leere Antwort als normalen Lauf. Das summierte sich zu 996 leeren Antworten, die als erfolgreich markiert waren. Fünf Monate lang zeigte das Dashboard Gemini als "zitiert uns selten" an, obwohl Gemini überhaupt nicht antwortete. Die gespeicherte Kostenspalte war auch falsch: Sie las die Kosten aus der falschen Ebene der Antwort, daher kommt die tatsächliche Zahl oben aus den rohen API-Antworten.
Wenn du deinen eigenen Tracker erstellst, überprüfe drei Dinge:
- Gibt jede Engine tatsächlich Antworttext zurück? Eine leere Antwort, die als "nicht zitiert" geloggt wird, sieht genau wie ein echtes Ergebnis aus.
- Wird das Modell, das du anfordernst, noch bereitgestellt? Fixiere ein Modell und melde einen Alert, wenn es verschwindet.
- Wird ein Task-Level-Fehler als Fehler gespeichert? Verlasse dich nicht allein auf den HTTP-Status, und verwandle einen fehlgeschlagenen Task nicht in eine leere Antwort.
Die Reparatur ist klein: Fordere ein aktuelles Gemini-Modell an und zeichne einen fehlgeschlagenen Task als Fehler auf. Die echte Lektion ist, dass eine stille Null überprüft werden muss, bevor du sie berichtest.
Was ich deswegen ändere
- Eine Seite pro Käuferfrage, für die ich zitiert werden will. 117 der 125 Zitierungen, die diese Seite gewonnen hat, stammen von Seiten, die um genau eine Frage herum aufgebaut sind. Der neue Leitfaden How to Rank in ChatGPT ist die ausführliche Version davon.
- Verzeichniseinträge für die London-Prompts. Keine London-Seite auf dieser Seite wurde für einen London-Prompt in sechs Monaten zitiert, während Clutch, DesignRush und Sortlist zitiert wurden. Diese Arbeit ist Verzeichnisse und Bewertungen, nicht mehr Seiten.
- Mehr Prompts, die gleiche wöchentliche Kadenz. Fünfzehn Prompts reichen aus, um Muster zu erkennen, und sind zu wenig, um zu verallgemeinern. Die nächsten Prompts behandeln AI-Visibility-Tools, das Thema der nächsten Beiträge hier.
- Gemini zurück, mit Checks. Die Zahlen werden erscheinen, sobald es ein paar Monate echter Antworten gibt.
Falls du die gleiche Analyse auf deine eigenen Prompts laufen lassen möchtest, das ist Teil der AI SEO und GEO Arbeit, die ich mache. Für einen schnellen Blick auf Google zuerst, das kostenlose AI Citation Checker testet, ob eine Seite in AI Overviews erscheint.
FAQ
Wie oft zitiert ChatGPT Quellen?
In dieser Studie hat GPT-4o mini über die API Quellen an 34,6 % seiner Antworten angehängt, mit Web-Suche bei jedem Aufruf aktiviert. Das Muster war deutlich: Es suchte jede Woche nach Prompts, die mit "Best" begannen, und nie nach Fragen, die als "how", "who should I hire" oder "should I" formuliert waren. Die Consumer-ChatGPT-App verwendet andere Modelle und könnte sich anders verhalten, daher behandle dies als das Verhalten eines Modells.
Wie viele Quellen zitiert Perplexity pro Antwort?
Das Sonar-Modell von Perplexity zitierte im Durchschnitt 10,2 Quellen pro Antwort über 868 Antworten. Der monatliche Durchschnitt schwankte zwischen 7,5 und 17,1, mit einem Höchststand im August 2026.
Welche Websites zitieren AI-Suchmaschinen am meisten?
Für diese 15 Käufer-Prompts zitierte Perplexity YouTube in 32,5 % der Antworten, Reddit in 29,8 %, Clutch in 15,2 %, Zapier in 14,3 % und LinkedIn in 13,2 %. Dein Thema wird seine eigenen führenden Domains haben. Überprüfe, welche Domains für deine Prompts zitiert werden, bevor du entscheidest, wo du deine Anstrengungen konzentrierst.
Wie lange dauert es, von Perplexity zitiert zu werden?
Für die Seiten hier kam die erste Zitierung zwischen fünf Tagen und etwa zehn Wochen nach Beginn des Trackings. Drei Seiten wurden zum ersten Mal in der gleichen Woche im Juli zitiert, als Perplexity begann, mehr Quellen an jede Antwort anzuhängen. Änderungen auf der Seite der Engine bewegten die Zahlen genauso sehr wie alles auf der Seite.
Sind LLM-Zitierungen stabil genug zum Tracking?
Innerhalb eines einzelnen Laufs ja: Kopien des gleichen Prompts teilten 86 % ihrer Quellen. Über Wochen hinweg viel weniger, mit 47 % Überlappung nach einer Woche und 9 % nach sechs Monaten. Verfolge den Anteil der Antworten, die dich über viele Prompts und Wochen hinweg zitieren, nicht eine einzelne Überprüfung oder Position.