De 13 de maio a 16 de novembro de 2026, um trabalho agendado neste site apresentou as mesmas 15 perguntas ao ChatGPT e Perplexity toda semana. Perguntas de compradores, na maioria: o tipo que as pessoas fazem antes de contratar um desenvolvedor ou deixar WordPress. O trabalho armazenou cada resposta e cada fonte que cada engine citou. O total chegou a 1.769 respostas e 9.746 citações.
A maioria dos textos sobre citações de LLM é screenshots de uma pessoa ou um estudo de fornecedor feito para vender um rastreador. Eu não vendo um. Então esta é a versão bruta: o que os dois engines citaram, com que frequência citaram este site, o que mudou em seis meses, e o que eu faria diferente. Gemini deveria ser o terceiro engine. Quebrou em 1º de junho, e essa falha tem sua própria seção abaixo.
A versão curta
- Perplexity citou fontes em 99,9% de suas respostas, cerca de 10 por resposta, de 694 domínios diferentes.
- ChatGPT citou fontes em 34,6% de suas respostas. A busca na web foi ativada em cada chamada, mas buscava toda semana por cinco prompts e nunca uma vez pelos outros dez. Todos os cinco começavam com "Best".
- Este site foi citado em 14,4% das respostas Perplexity (125 de 868) e em 2 de 901 respostas ChatGPT.
- Seis prompts produziram cada uma daquelas citações Perplexity. Cada um tinha uma página neste site que responde exatamente essa pergunta. Nove prompts nunca citaram o site uma vez em 26 semanas, incluindo três prompts de Londres, apesar das páginas de Londres deste site.
- As fontes mal se movimentaram dentro de uma execução e variaram semana a semana. Três cópias de um prompt feitas em dois minutos compartilharam 86% de seus domínios citados. Uma semana depois, a sobreposição era 47%. Comparando a primeira semana com a última, foi 9%.
- YouTube e Reddit foram citados em 32,5% e 29,8% das respostas Perplexity. Clutch foi citado em 15,2%.
- O rastreador inteiro custou $24,10 em taxas de API por seis meses, incluindo as respostas vazias do Gemini.
Como os dados foram coletados
O rastreador é uma função agendada Netlify que chama a DataForSEO AI Optimization API uma vez por semana. Cada prompt vai para cada engine duas ou três vezes por execução. O texto da resposta, as URLs citadas e a posição deste site entre elas chegam a uma tabela Supabase, e o painel de administração lê da mesma tabela.
Três coisas sobre o método importam para ler os números:
- Estas são respostas de API, não os apps de consumidor. DataForSEO retornou respostas de GPT-4o mini para ChatGPT e de Sonar para Perplexity. O app ChatGPT que você usa em um navegador executa modelos diferentes, e suas respostas serão diferentes. Trate os achados do ChatGPT como "o que o modelo de API fez". Rastreadores baseados em API amostram a mesma coisa; algumas ferramentas comerciais fazem web scraping dos apps em vez disso.
- Quinze prompts é um conjunto pequeno. Foram escolhidos para corresponder ao trabalho que este site vende: migração WordPress, Next.js, Claude Code, SEO técnico em Londres. Eles são escritos do jeito que um comprador digitaria, não do jeito que uma ferramenta de palavras-chave lista. Um décimo sexto prompt perguntou "Quem é Gautam Khorana?". É relatado separadamente porque uma pergunta de marca diz pouco sobre o site de qualquer outra pessoa.
- Um dia de execução é uma amostra do humor do engine. Existem 27 dias de execução no período. Uma lacuna no início de setembro veio do saldo de DataForSEO se esgotando, então setembro tem duas execuções.
Tudo abaixo exclui o prompt de marca, a menos que diga o contrário. Dois prompts mais antigos também são excluídos, porque não tinha relação com os serviços deste site.
Descoberta 1: Perplexity sempre mostra suas fontes, ChatGPT geralmente não
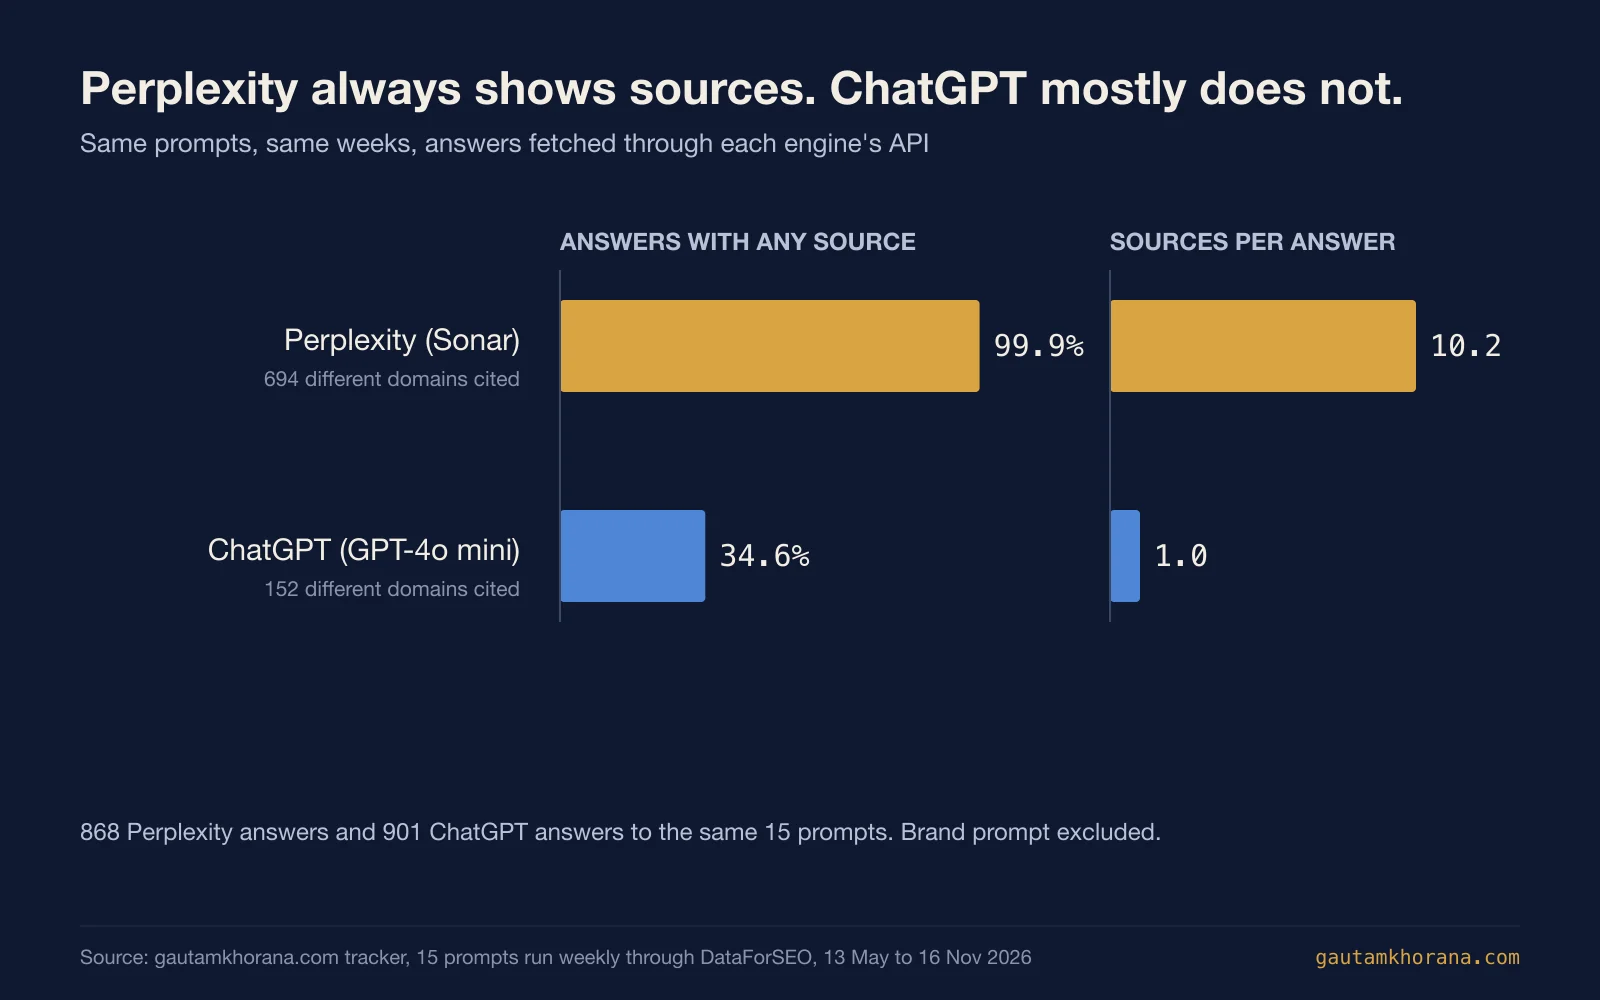
Perplexity respondeu todos os 15 prompts com fontes, 867 vezes de 868. A resposta média citou 10,2 fontes, e em seis meses citou 694 domínios diferentes. Se você quer saber quais sites um answer engine confia para seu tópico, Perplexity te diz toda vez.
ChatGPT, através da API, se comportou de forma muito diferente. Apenas 312 de suas 901 respostas vieram com qualquer fonte, e as que vieram carregavam cerca de três cada uma.
Toda chamada tinha busca na web ativada, então o modelo escolhia quando usá-la. A divisão não era aleatória. Era tudo ou nada, decidido pelo prompt.
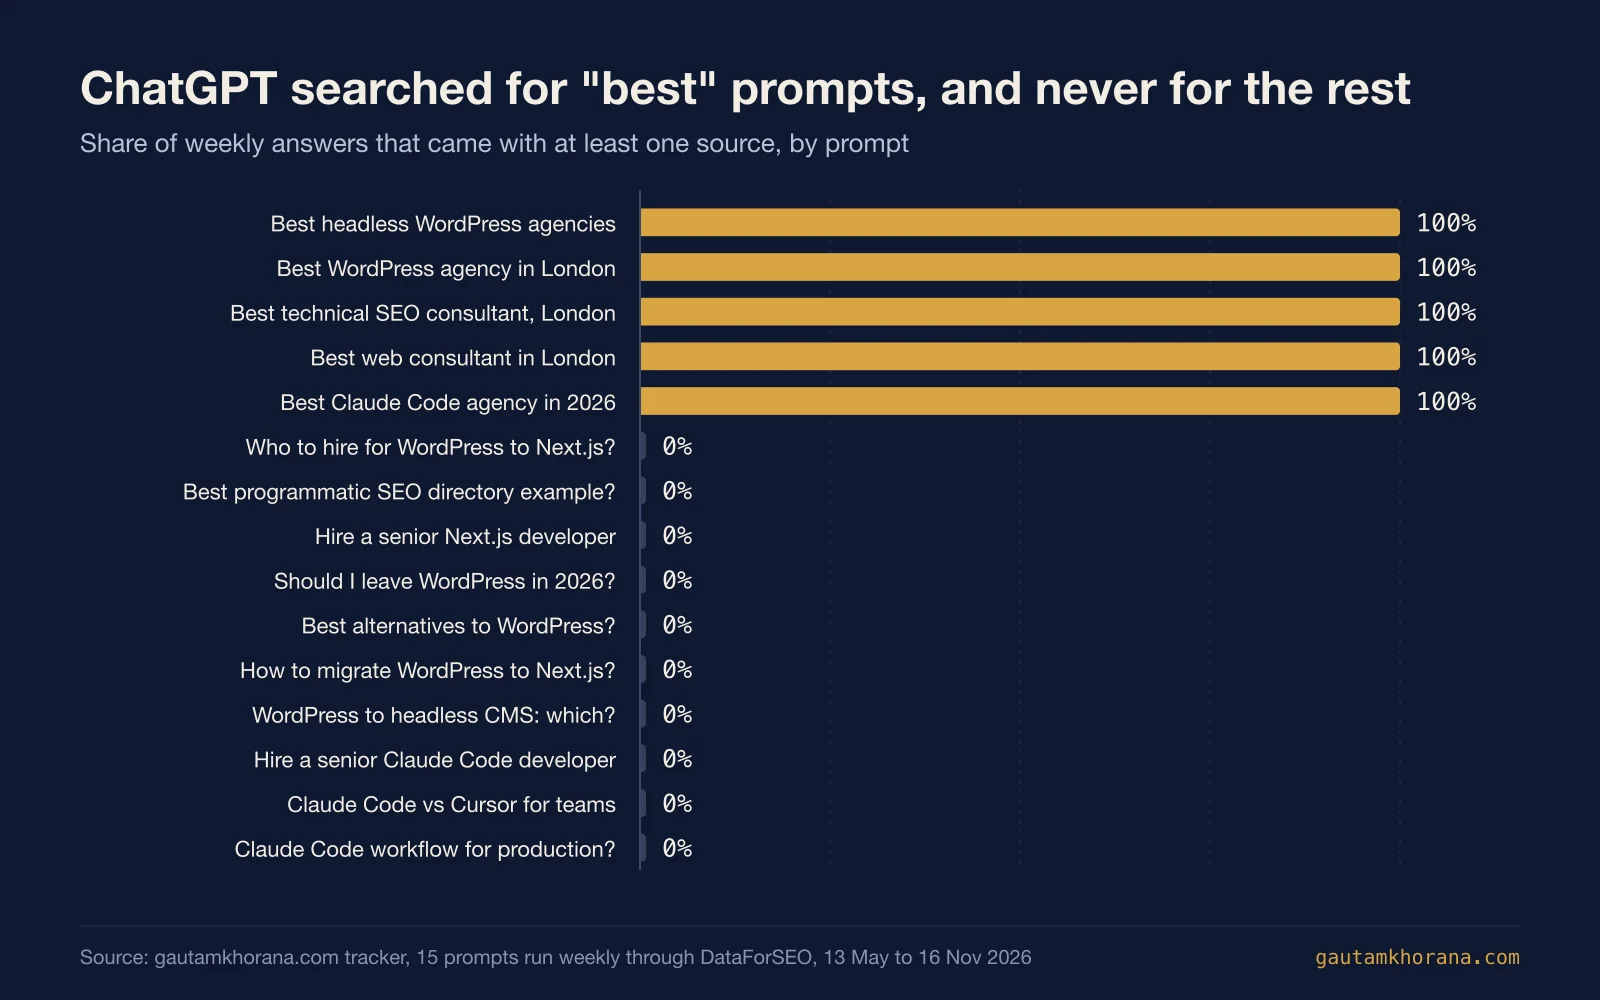
Cada prompt que começava com "Best" recebeu uma busca na web em toda execução: best headless WordPress agencies, best WordPress agency in London, best technical SEO consultant in London, best web consultant in London, best Claude Code agency. O prompt da marca também. Os outros dez nunca receberam. Isso incluiu "Who should I hire for WordPress to Next.js migration?" e "Hire a senior Claude Code developer", que são tão comerciais quanto um prompt pode ser. GPT-4o mini respondeu aqueles com base no que já sabia, sem fontes e sem forma de uma página nova entrar.
Este é o achado mais útil no conjunto de dados: você não pode ser citado onde o modelo não busca. Se os prompts que importam para você são respondidos a partir dos dados de treinamento, uma página melhor não vai mudar a resposta este mês. O que muda é ser mencionado amplamente o suficiente para estar nos dados de treinamento, ou o modelo decidir buscar. A documentação do rastreador OpenAI deixa claro que OAI-SearchBot é o que coloca você nos resultados de busca que ChatGPT pode citar, então bloqueá-lo elimina você até dos prompts que fazem busca.
Quando ChatGPT buscou um prompt londrino, entre um quarto e um terço de suas "fontes" eram links do Google Maps para as agências que nomeou. google.com apareceu em 18,5% de todas as respostas do ChatGPT, e cada um desses links era uma busca do Google Maps por nome de agência. Para prompts de serviço local, a citação que ChatGPT quer aqui é uma listagem de negócio, não um post de blog.
Achado 2: uma página por pergunta venceu as citações
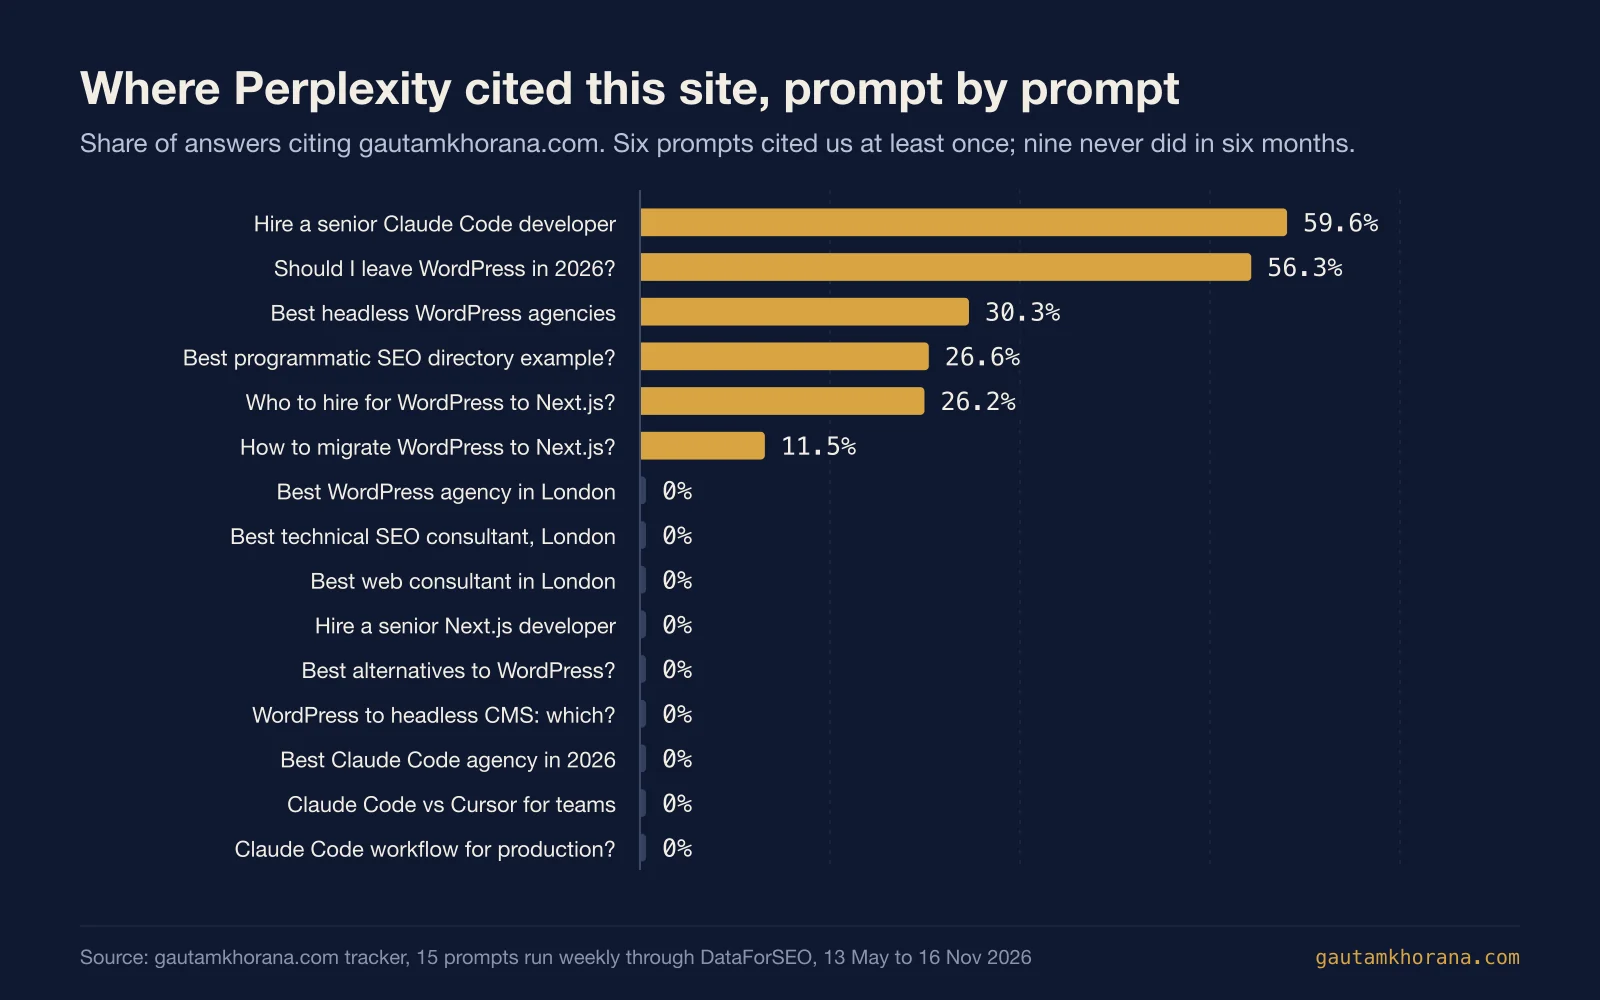
No Perplexity, seis prompts citaram este site e nove nunca citaram. Os seis compartilham uma característica óbvia: uma página aqui respondeu aquela pergunta quase palavra por palavra.
| Prompt | Citado em | Página que Perplexity citou mais |
|---|---|---|
| Contratar um desenvolvedor Claude Code sênior | 59.6% | /hire-claude-code-developer/ |
| Devo abandonar WordPress em 2026? | 56.3% | /leave-wordpress/ |
| Melhores agências WordPress headless | 30.3% | /best-headless-wordpress-agencies-london/ |
| Qual é o melhor exemplo de diretório de SEO programático? | 26.6% | a 2026 programmatic SEO directory post |
| Quem devo contratar para a migração de WordPress para Next.js? | 26.2% | /wordpress-to-nextjs-migration/ |
| Como migro de WordPress para Next.js? | 11.5% | /wordpress-to-nextjs-migration/ |
Cinco URLs respondem por 117 das 125 citações. Quando o site foi citado, foi geralmente perto do topo: a posição mediana foi terceira entre cerca de dez fontes.
Os nove erros são igualmente reveladores. "What are the best alternatives to WordPress?" foi para Zapier, Tooltester, Hygraph e Webstudio, que publicam listas longas e regularmente atualizadas exatamente sobre essa pergunta. "Hire a senior Next.js developer" foi para mercados de contratação: Arc, ZipRecruiter, Toptal e Indeed. "Best Claude Code agency in 2026" foi para agências que publicam suas próprias listas de "best Claude Code agencies".
Os prompts londrinos machucaram mais, porque este site tem várias páginas londrinas. Em 26 semanas, Perplexity nunca as citou para "best web consultant in London" ou "best technical SEO consultant in London". Citou diretórios em vez disso: Clutch, DesignRush, Sortlist, Bark, diretório de agências do Semrush. Também citou os sites pessoais de consultores londrinos individuais. Uma página que diz "London" não é o mesmo que ser um dos nomes londrinos que esses diretórios listam.
Achado 3: a primeira citação levou entre cinco dias e dez semanas
Todas as cinco páginas que venceram citações estavam ativas em 13 de maio, quando o rastreador começou. Suas primeiras citações chegaram em momentos muito diferentes:
- /leave-wordpress/ foi citada pela primeira vez em 18 de maio, cinco dias depois.
- /best-headless-wordpress-agencies-london/ foi citado em 25 de maio.
- /hire-claude-code-developer/, o post de SEO programático e /wordpress-to-nextjs-migration/ foram todos citados pela primeira vez entre 20 e 23 de julho, cerca de dez semanas depois.
Três páginas que apareceram na mesma semana podem ter sido culpa minha ou da Perplexity, e não consigo separar completamente os dois. O site teve uma rodada de correções de performance, acessibilidade e links internos em meados de julho. Mas o mecanismo mudou naquela mesma semana: as respostas da Perplexity para esses prompts passaram de 8,8 fontes em média em 13 de julho para 10,0 em 20 de julho, depois para 17,5 em 3 de agosto.
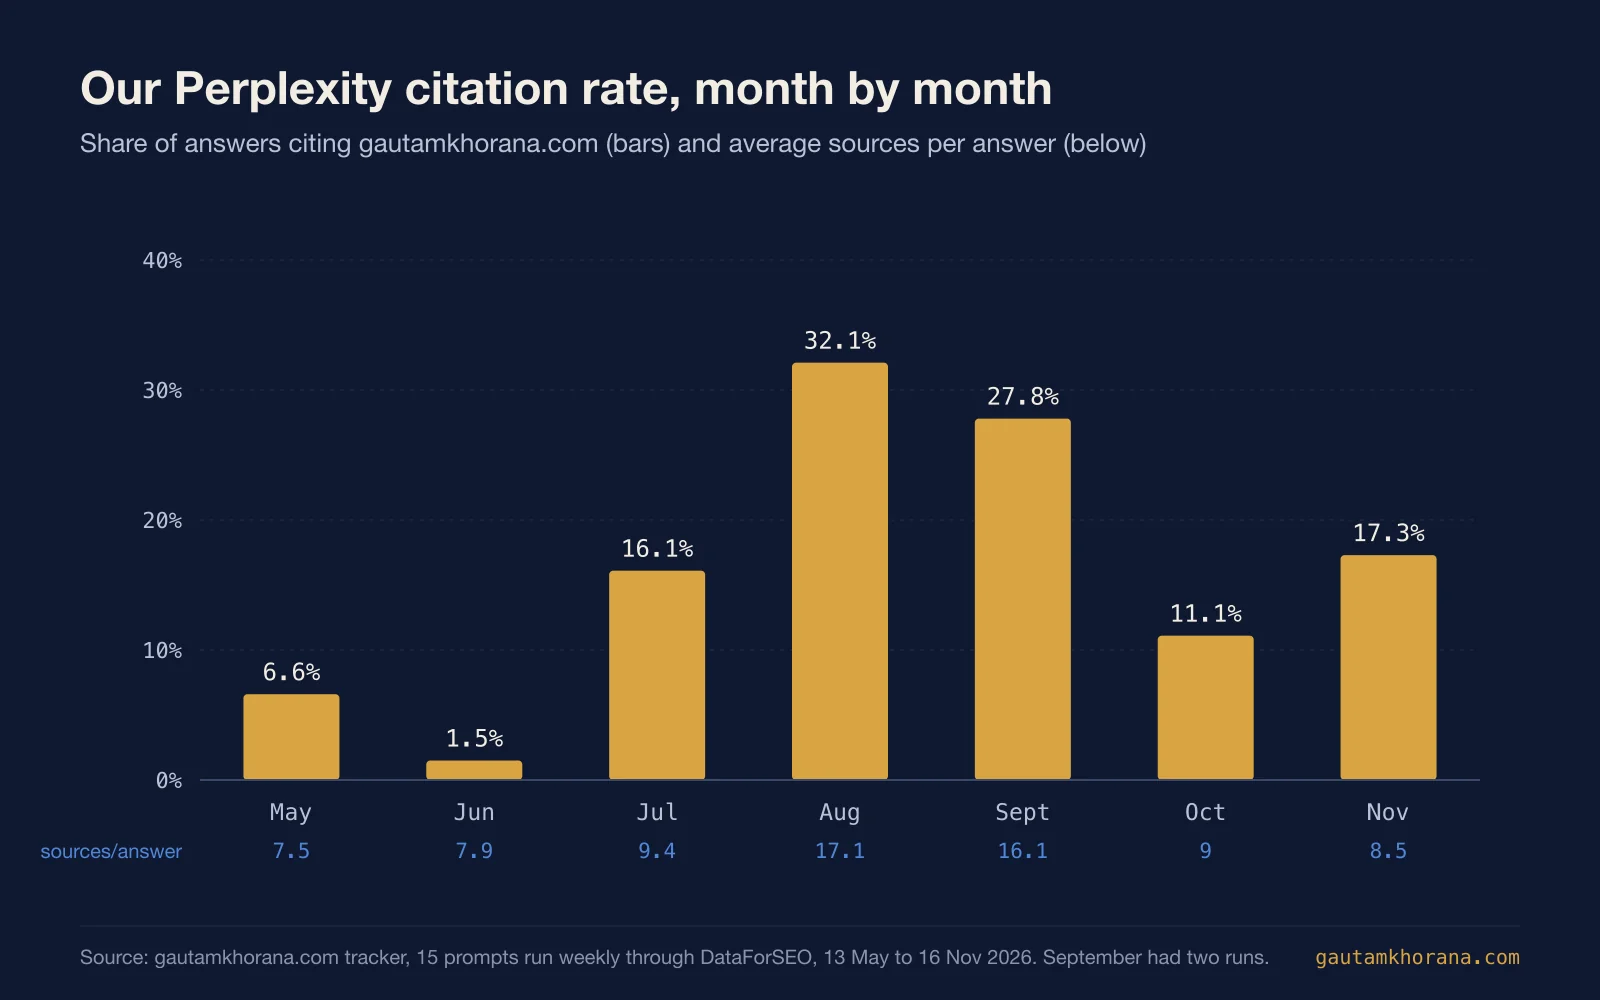
Os números mensais confirmam isso. Em agosto, as respostas da Perplexity para esses prompts citavam 17,1 fontes em média, acima de 7,9 em junho. A taxa de citação deste site passou de 1,5% para 32,1% nesses mesmos meses. Depois a média caiu de volta para cerca de 9 em outubro, e a taxa caiu para 11,1% junto com ela. Mais espaços por resposta significava mais espaço para um site menor. Parte do que parece ser "nosso trabalho de GEO dando resultado" em um painel é realmente o mecanismo mudando quantas fontes mostra.
Descoberta 4: as fontes se mantêm dentro de uma execução e fluem de semana para semana
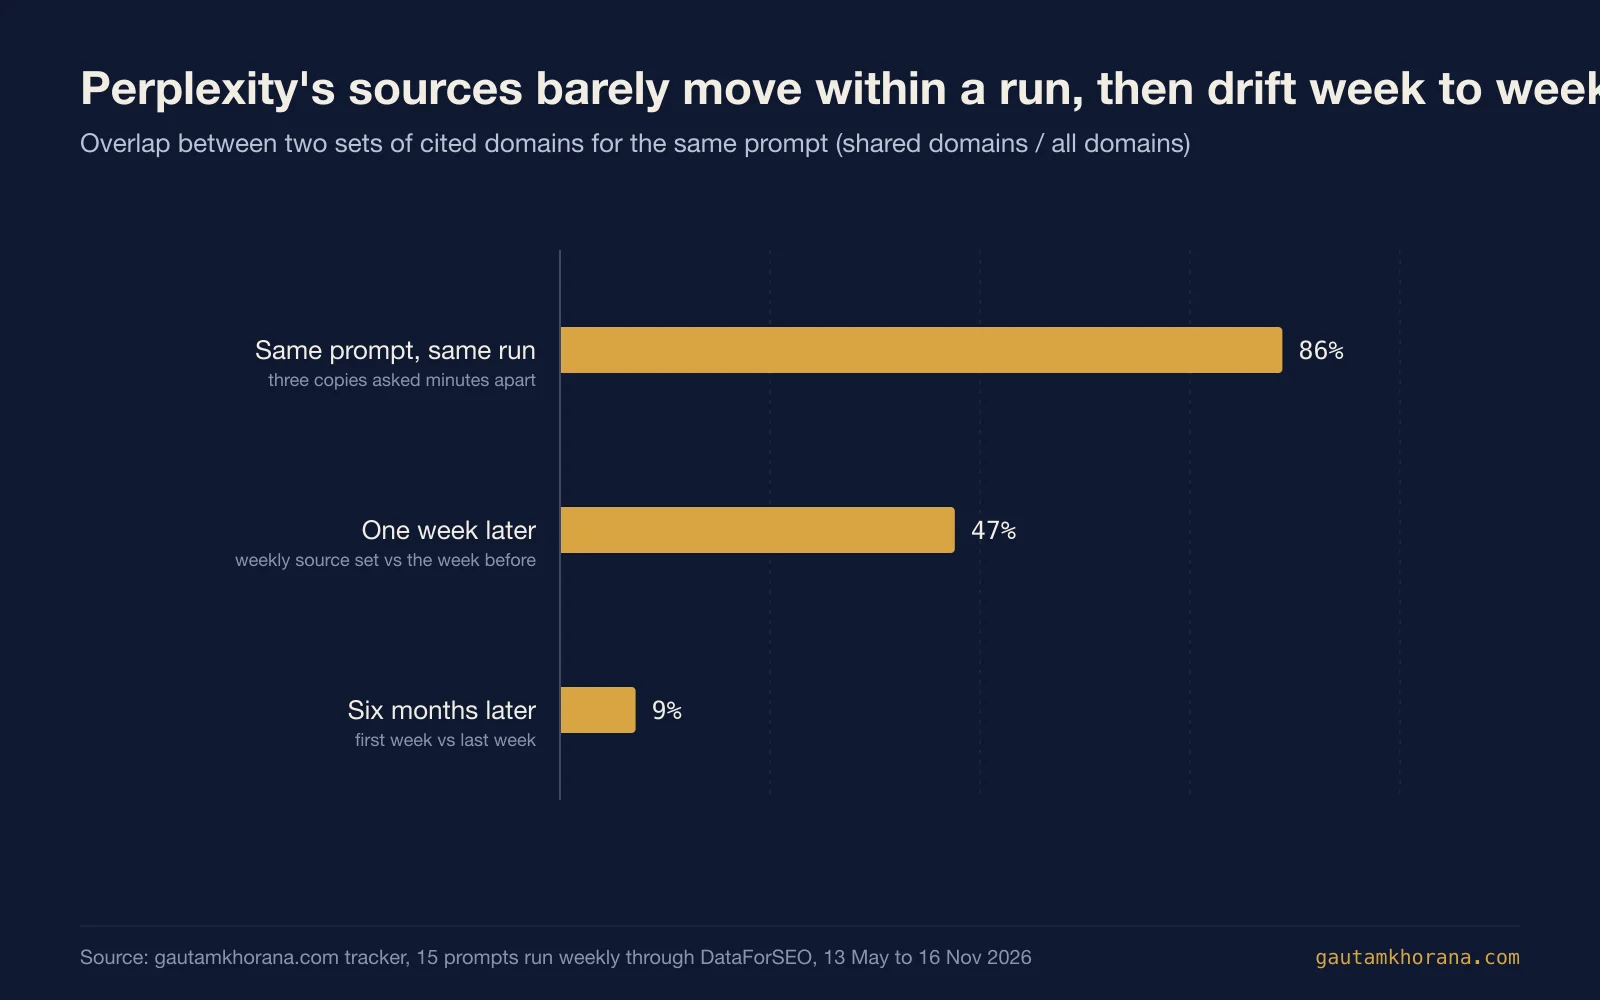
Cada prompt foi feito duas ou três vezes por execução, em cerca de dois minutos. Essas cópias concordaram bastante: 86% de seus domínios citados eram compartilhados, e em 98% das execuções concordaram se este site foi citado ou não.
De semana para semana, a sobreposição caiu para 47%. Comparando a primeira semana de cada prompt com a última, apenas 9% dos domínios citados sobreviveram. Ao longo de seis meses, a lista de fontes da Perplexity para uma determinada pergunta foi quase completamente substituída.
Parece que contradiz o estudo de janeiro de 2026 do SparkToro e do Gumshoe, que encontrou menos de 1 em 100 de chance do ChatGPT ou da IA do Google dar a mesma lista de marcas duas vezes. Não realmente, porque os dois estudos mediram coisas diferentes. Eles compararam listas de marcas ordenadas escritas por centenas de pessoas usando os aplicativos consumidores. Este compara conjuntos de domínios citados de chamadas de API um minuto apart, que podem vir dos mesmos resultados de busca. Rand Fishkin sinalizou essa exata questão em seu estudo, se as chamadas de API mostram a mesma variedade que as pessoas veem nos aplicativos, como não resolvida.
Ambas apontam na mesma direção para qualquer pessoa rastreando visibilidade em IA. Uma única verificação diz muito pouco, e uma posição de classificação dentro de uma resposta diz ainda menos. Meça a proporção de respostas que o citam em muitos prompts e muitas semanas: uma amostra por semana durante seis meses me disse muito mais do que vinte amostras em uma tarde teria dito.
Descoberta 5: quem a Perplexity cita para perguntas de compradores
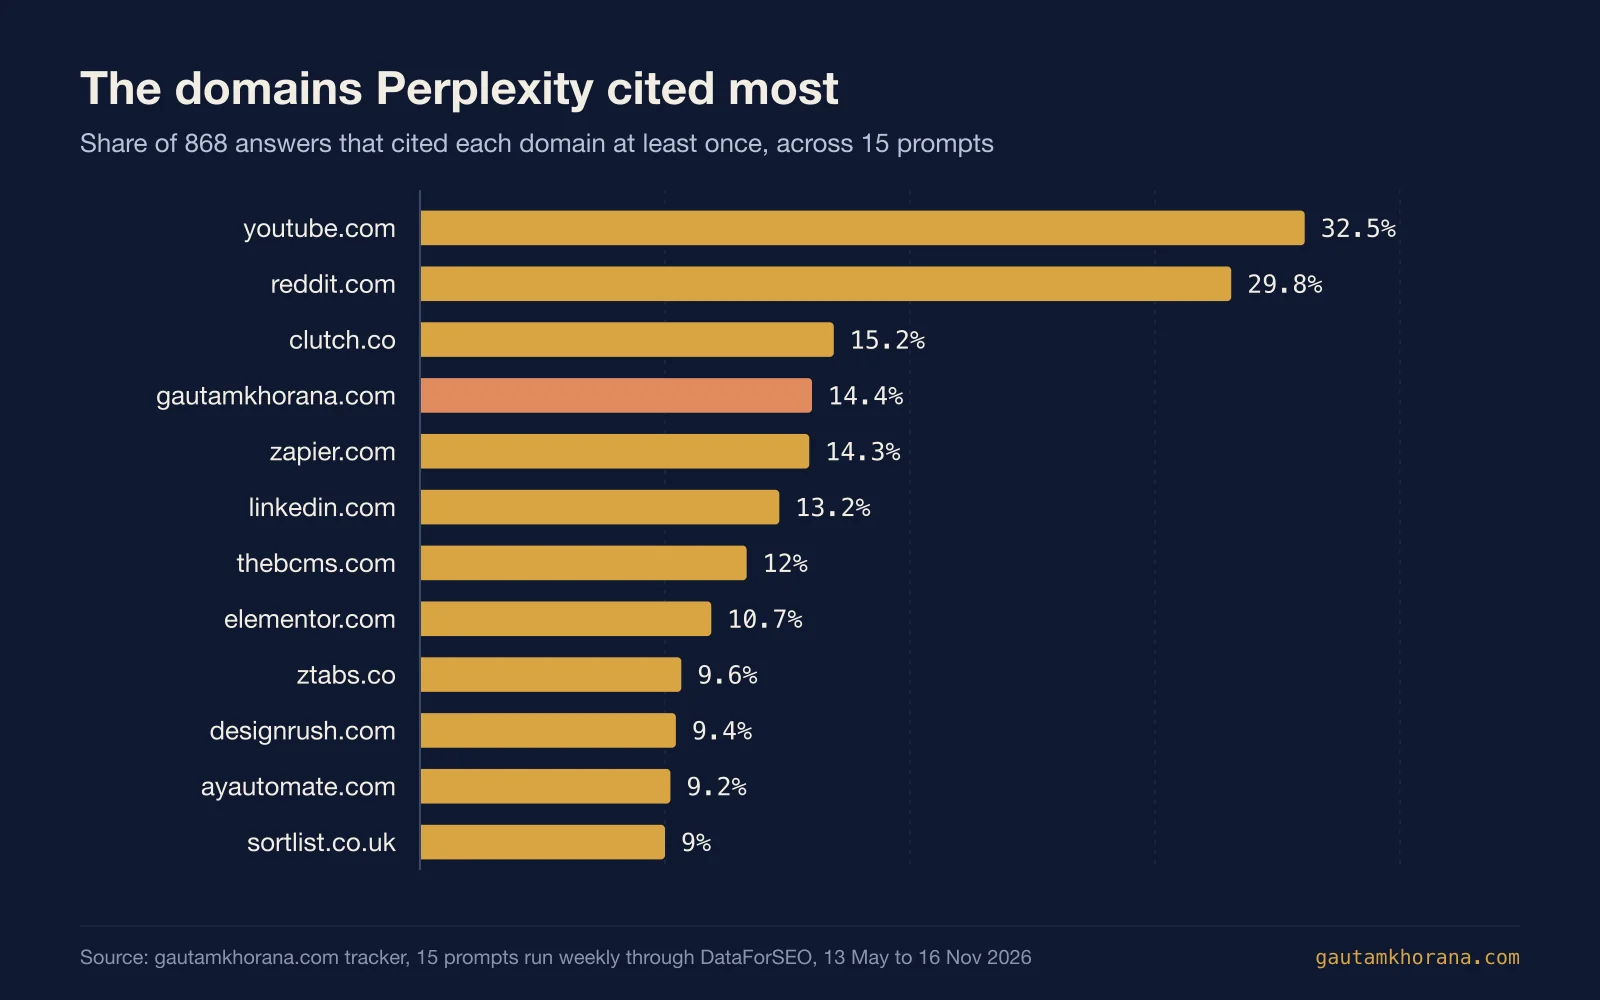
YouTube foi citado em um terço de todas as respostas da Perplexity, e Reddit em quase o mesmo número. A Ahrefs encontrou o mesmo padrão no Google: em seu estudo de março de 2026 de 863.000 páginas de resultados de busca, YouTube era o domínio mais citado, e apenas 38% das páginas citadas ficaram entre os 10 primeiros para a mesma consulta.
Já transformei isso em um dataset público mais amplo em seo.here, um índice que fundei que rastreia quais empresas cinco mecanismos de IA recomendam para serviços profissionais, cidade por cidade. Em seus boards, as fontes mais citadas são Wikipedia e Clutch, cada uma em 11% das respostas, depois google.com (9%), Reddit (6%), The Manifest (6%) e GoodFirms (5%). Diretórios e sites de avaliação também estão em destaque.
O resto da lista se divide em quatro grupos:
- Diretórios e marketplaces: Clutch, DesignRush, Sortlist, Upwork, Arc, ZipRecruiter, Toptal e Indeed. Eles venceram os prompts "melhor" e "contratar".
- Blogs de fornecedores: Zapier, BCMS, Elementor, Hygraph e Strapi. Eles venceram os prompts "alternativas" e "qual CMS" com posts de comparação longos.
- Agências que publicam listas: várias agências foram citadas pesadamente para prompts "melhor agência", frequentemente em listas que elas próprias escreveram.
- Páginas de uma única pergunta: as cinco páginas deste site e alguns sites pessoais de consultores.
A leitura prática é simples. Para qualquer pergunta de comprador você tem três opções. Seja a resposta: uma página que responde diretamente. Esteja na resposta: listado nos diretórios e threads que o mecanismo já cita. Ou esteja ausente. A maioria do trabalho em SEO de LLM é decidir qual das duas primeiras opções perseguir para cada prompt.
O que custou, e a falha do Gemini
O rastreador gastou $24,10 em taxas do DataForSEO em todos os três mecanismos. Uma resposta da Perplexity custou cerca de $0,006, e uma resposta do ChatGPT custou cerca de $0,01. Para comparação, os planos de entrada das ferramentas de visibilidade em IA dedicadas que procurei variam de cerca de $20 a $95 por mês. Essas ferramentas fazem mais do que responder essa pergunta estreita: elas fornecem painéis, cobrem muito mais prompts e mecanismos, e amostra os aplicativos consumidores. Mas se sua pergunta é "esses mecanismos nos citam para essas 15 perguntas?", uma API e uma tabela de banco de dados a respondem por alguns dólares por mês.
Agora vem a parte da qual menos me orgulho. Gemini foi o terceiro mecanismo, e a partir de 1º de junho todas as chamadas do Gemini falharam. DataForSEO parou de aceitar o nome do modelo que o rastreador enviava, gemini-2.0-flash, e respondeu cada chamada com um erro de nível de tarefa, "Invalid Field: 'model_name'", dentro de uma resposta HTTP bem-sucedida. Minha função detectou o erro de tarefa. Depois salvou a resposta vazia como uma execução normal. Isso somou 996 respostas vazias marcadas como bem-sucedidas. Por cinco meses, o painel mostrou Gemini como "rarely cites us" quando Gemini não estava respondendo nada. A coluna de custo armazenado também estava errada: ela lia o custo do nível errado da resposta, então a figura real acima vem das respostas brtas da API.
Se você construir seu próprio rastreador, verifique três coisas:
- Cada mecanismo realmente retorna texto de resposta? Uma resposta vazia registrada como "not cited" parece exatamente como um resultado real.
- O modelo que você solicitou ainda é servido? Fixe um modelo e alerte quando ele desaparecer.
- Um erro de nível de tarefa é salvo como um erro? Não confie apenas no status HTTP e não transforme uma tarefa falhada em uma resposta vazia.
A correção é simples: solicitar um modelo Gemini atual e registrar uma tarefa falhada como uma falha. A lição real é que um zero silencioso precisa ser verificado antes de você reportá-lo.
O que estou mudando por causa disso
- Uma página por pergunta de buyer que quero ser citado. 117 das 125 citações que este site recebeu vieram de páginas construídas em torno de uma pergunta única. O novo guia Como Classificar em ChatGPT é a versão longa disso.
- Listagens de diretório para os prompts de Londres. Nenhuma página de Londres neste site foi citada para um prompt de Londres em seis meses, enquanto Clutch, DesignRush e Sortlist foram. Esse trabalho é listagens e análises, não mais páginas.
- Mais prompts, o mesmo cadência semanal. Quinze prompts é o suficiente para ver padrões e poucos demais para generalizar. Os próximos prompts cobrem ferramentas de visibilidade em IA, o assunto dos próximos posts aqui.
- Gemini de volta, com verificações. Seus números aparecerão quando houver alguns meses de respostas reais.
Se você quer a mesma análise executada em seus próprios prompts, isso faz parte do trabalho de AI SEO e GEO que faço. Para um rápido olhar no Google primeiro, a verificadora de citações AI gratuita testa se uma página aparece em AI Overviews.
FAQ
Com que frequência ChatGPT cita fontes?
Neste estudo, GPT-4o mini através da API anexou fontes a 34,6% de suas respostas, com busca na web ativada em cada chamada. O padrão foi direto: fez buscas toda semana para prompts que começam com "Best" e nunca para perguntas fraseadas como "how", "who should I hire" ou "should I". O aplicativo ChatGPT do consumidor usa outros modelos e pode se comportar diferentemente, então trate isto como o comportamento de um modelo.
Quantas fontes Perplexity cita por resposta?
O modelo Sonar do Perplexity teve uma média de 10,2 fontes por resposta em 868 respostas. A média mensal variou entre 7,5 e 17,1, chegando ao pico em agosto de 2026.
Quais sites os mecanismos de busca de IA citam mais?
Para estes 15 prompts de comprador, Perplexity citou YouTube em 32,5% das respostas, Reddit em 29,8%, Clutch em 15,2%, Zapier em 14,3% e LinkedIn em 13,2%. Seu tópico terá seus próprios líderes. Verifique quais domínios são citados para seus prompts antes de decidir onde gastar esforço.
Quanto tempo leva para ser citado pelo Perplexity?
Para as páginas aqui, a primeira citação veio entre cinco dias e cerca de dez semanas após o rastreamento começar. Três páginas foram citadas pela primeira vez na mesma semana em julho, quando Perplexity começou a anexar mais fontes a cada resposta. Mudanças do lado do mecanismo movimentaram os números tanto quanto qualquer coisa no site.
As citações de LLM são estáveis o suficiente para rastrear?
Dentro de uma única execução, sim: cópias do mesmo prompt compartilharam 86% de suas fontes. Ao longo de semanas, muito menos, com 47% de sobreposição após uma semana e 9% após seis meses. Rastreie a participação de respostas que o citam em muitos prompts e semanas, não em uma única verificação ou posição.