Du 13 mai au 16 novembre 2026, une tâche programmée sur ce site a posé les mêmes 15 questions à ChatGPT et Perplexity chaque semaine. Surtout des questions d'acheteurs : le type de questions que les gens se posent avant d'embaucher un développeur ou de quitter WordPress. La tâche a enregistré chaque réponse et chaque source que chaque moteur a citée. Le total s'est élevé à 1 769 réponses et 9 746 citations.
La plupart des écrits sur les citations LLM sont soit des captures d'écran d'une personne, soit une étude de fournisseur conçue pour vendre un suivi. Je n'en vends pas. Voici donc la version brute : ce que les deux moteurs ont cité, à quelle fréquence ils ont cité ce site, ce qui a changé en six mois, et ce que je ferais différemment. Gemini était censé être le troisième moteur. Il s'est arrêté le 1er juin, et cette défaillance a sa propre section ci-dessous.
La version courte
- Perplexity a cité des sources dans 99,9 % de ses réponses, environ 10 par réponse, provenant de 694 domaines différents.
- ChatGPT a cité des sources dans 34,6 % de ses réponses. La recherche web était activée à chaque appel, mais elle a cherché chaque semaine pour cinq invites et jamais une seule fois pour les dix autres. Les cinq premiers ont commencé par « Best ».
- Ce site a été cité dans 14,4 % des réponses de Perplexity (125 sur 868) et dans 2 réponses de ChatGPT sur 901.
- Six invites ont produit chacune de ces citations de Perplexity. Chacune avait une page sur ce site qui répond à cette question exacte. Neuf invites n'ont jamais cité le site une seule fois en 26 semaines, y compris trois invites sur Londres, malgré les pages Londres de ce site.
- Les sources ont à peine bougé au cours d'une exécution et ont divergé d'une semaine à l'autre. Trois copies d'une invite posée en deux minutes partageaient 86 % de leurs domaines cités. Une semaine plus tard, le chevauchement était de 47 %. En comparant la première semaine avec la dernière, il était de 9 %.
- YouTube et Reddit ont été cités dans 32,5 % et 29,8 % des réponses de Perplexity. Clutch a été cité dans 15,2 %.
- Le suivi complet a coûté 24,10 $ en frais d'API pour six mois, réponses vides de Gemini incluses.
Comment les données ont été collectées
Le suivi est une fonction programmée Netlify qui appelle l'API d'optimisation IA de DataForSEO une fois par semaine. Chaque invite est envoyée à chaque moteur deux ou trois fois par exécution. Le texte de la réponse, les URLs citées et la position de ce site parmi elles se retrouvent dans une table Supabase, et le tableau de bord administrateur lit depuis la même table.
Trois choses concernant la méthode comptent pour lire les chiffres :
- Ce sont des réponses API, pas les applications consommateur. DataForSEO a retourné des réponses de GPT-4o mini pour ChatGPT et de Sonar pour Perplexity. L'application ChatGPT que tu utilises dans un navigateur exécute des modèles différents, et ses réponses seront différentes. Considère les résultats de ChatGPT comme « ce que le modèle API a fait ». Les suivis basés sur API échantillonnent la même chose ; certains outils commerciaux font plutôt du scraping des applications.
- Quinze invites, c'est un petit ensemble. Elles ont été choisies pour correspondre au travail que ce site vend : migration WordPress, Next.js, Claude Code, SEO technique à Londres. Elles sont rédigées comme un acheteur les taperait, pas comme un outil de mots-clés les listerait. Une seizième invite demandait « Who is Gautam Khorana? ». Elle est rapportée séparément car une question de marque t'en dit peu sur le site de quelqu'un d'autre.
- Un jour d'exécution est un échantillon de l'humeur du moteur. Il y a 27 jours d'exécution dans la période. Une interruption en début septembre provenait de l'épuisement du solde DataForSEO, donc septembre a deux exécutions.
Tout ce qui suit exclut l'invite de marque sauf indication contraire. Deux invites plus anciennes sont également exclues, car elles n'étaient pas liées aux services de ce site.
Conclusion 1 : Perplexity affiche toujours ses sources, ChatGPT pour la plupart non
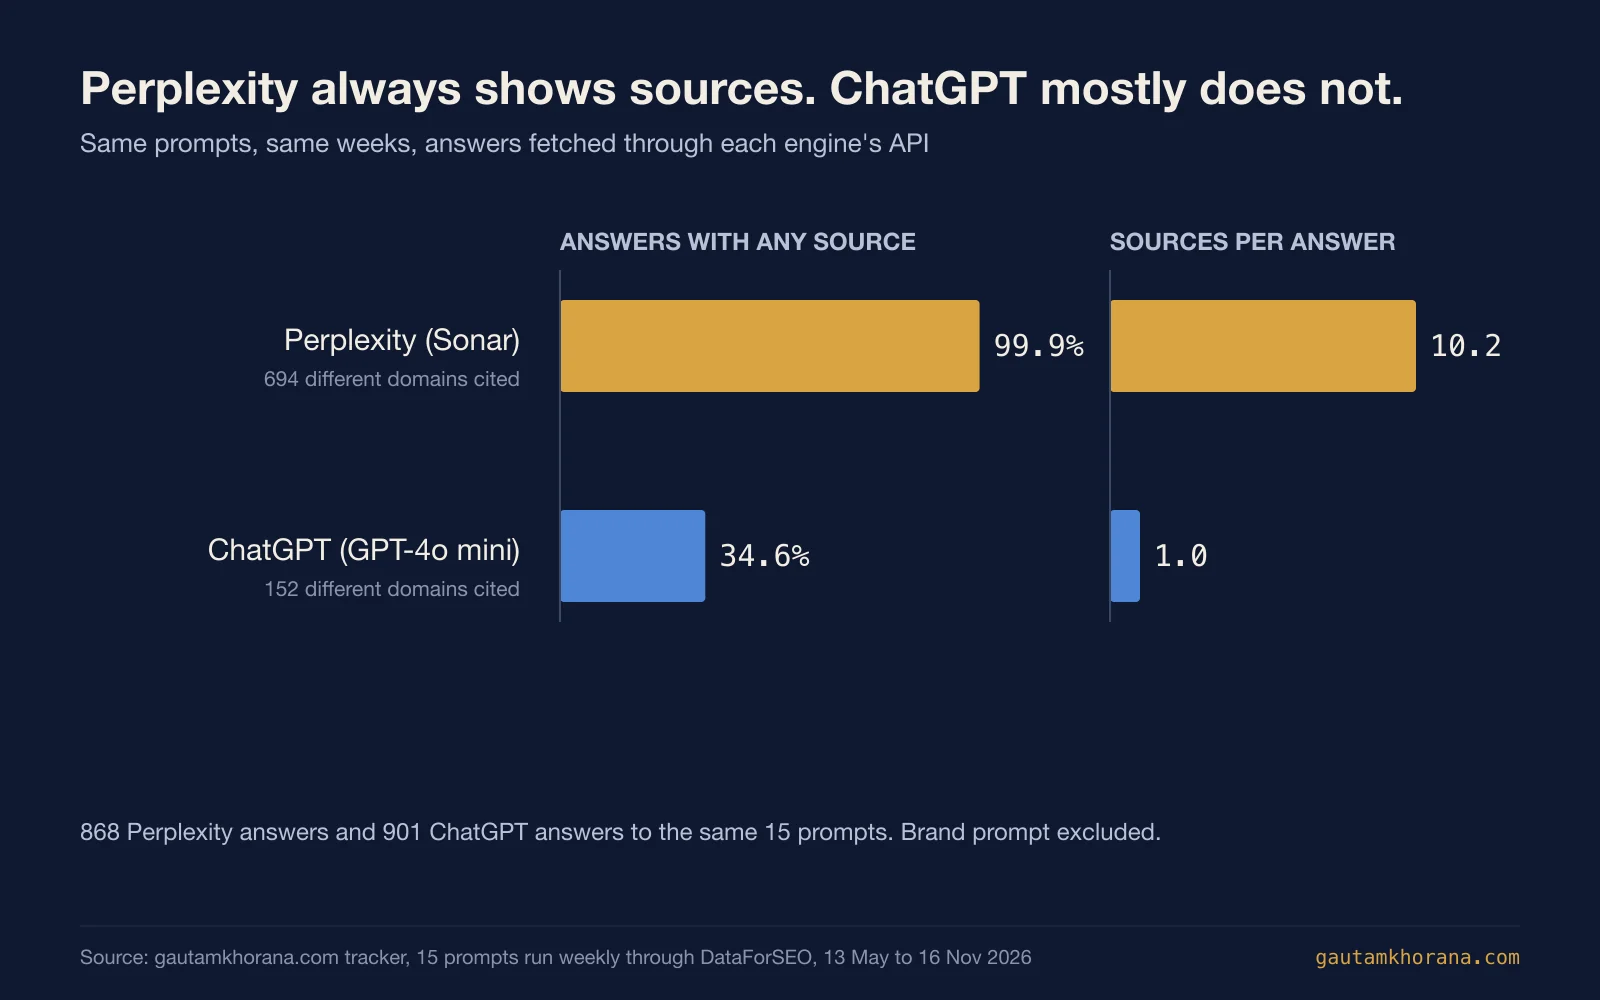
Perplexity a répondu aux 15 invites avec des sources, 867 fois sur 868. La réponse moyenne citait 10,2 sources, et sur six mois, elle a cité 694 domaines différents. Si tu veux savoir quels sites un moteur de réponse fait confiance pour ton sujet, Perplexity te le dit chaque fois.
ChatGPT, via l'API, s'est comporté très différemment. Seulement 312 de ses 901 réponses étaient accompagnées d'une source, et celles qui l'étaient en contenaient environ trois chacune.
Chaque appel avait la recherche web activée, donc le modèle choisissait quand l'utiliser. La répartition n'était pas aléatoire. C'était tout ou rien, décidé par le prompt.
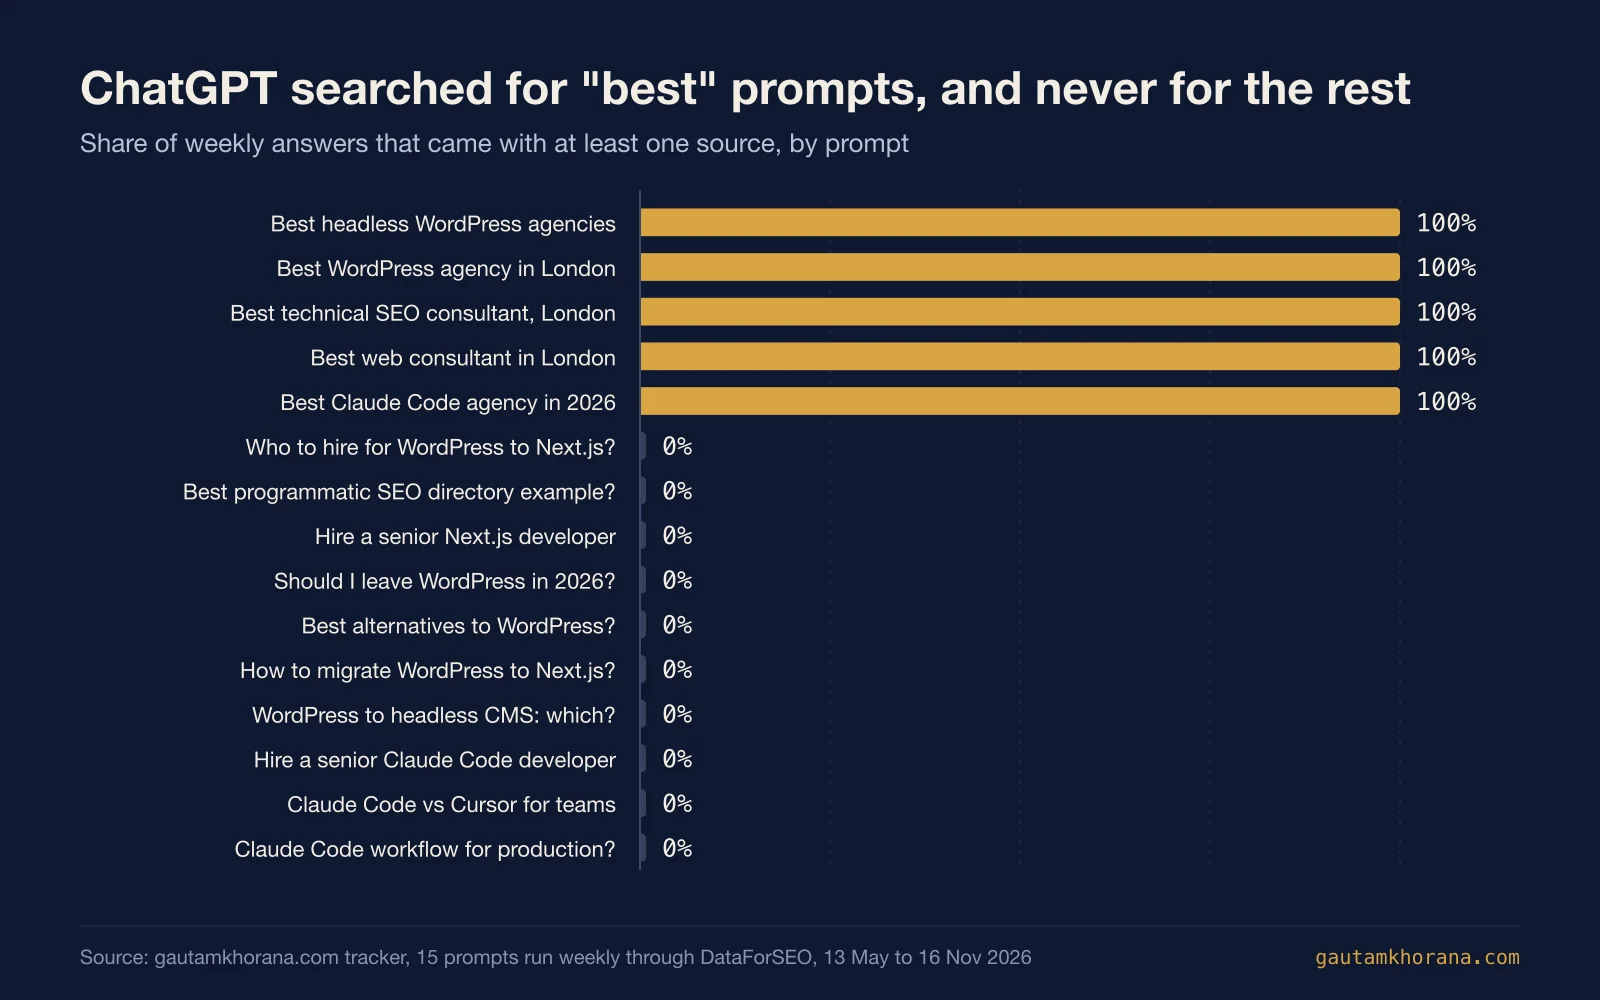
Chaque prompt commençant par "Best" a reçu une recherche web à chaque exécution : best headless WordPress agencies, best WordPress agency in London, best technical SEO consultant in London, best web consultant in London, best Claude Code agency. Le prompt de marque aussi. Les dix autres n'en ont jamais eu une. Cela incluait "Who should I hire for WordPress to Next.js migration?" et "Hire a senior Claude Code developer", qui sont aussi commerciaux qu'un prompt peut l'être. GPT-4o mini a répondu à ceux-ci à partir de ce qu'il savait déjà, sans sources et sans moyen pour une nouvelle page d'entrer.
C'est la découverte la plus utile de l'ensemble de données : vous ne pouvez pas être cité où le modèle ne cherche pas. Si les prompts qui vous importent sont répondus à partir des données d'entraînement, une meilleure page ne changera pas la réponse ce mois-ci. Ce qui la change, c'est être mentionné assez largement pour être dans les données d'entraînement, ou le modèle décidant de chercher. La documentation du crawleur OpenAI est claire : OAI-SearchBot est ce qui vous met dans les résultats de recherche que ChatGPT peut citer, donc le bloquer vous exclut même des prompts qui font une recherche.
Quand ChatGPT a cherché un prompt londien, entre un quart et un tiers de ses "sources" étaient des liens Google Maps vers les agences qu'il nommait. google.com est apparu dans 18,5 % de toutes les réponses de ChatGPT, et chaque lien était une recherche Google Maps pour un nom d'agence. Pour les prompts de services locaux, la citation que ChatGPT veut ici est une fiche commerciale, pas un article de blog.
Découverte 2 : une page par question a remporté les citations
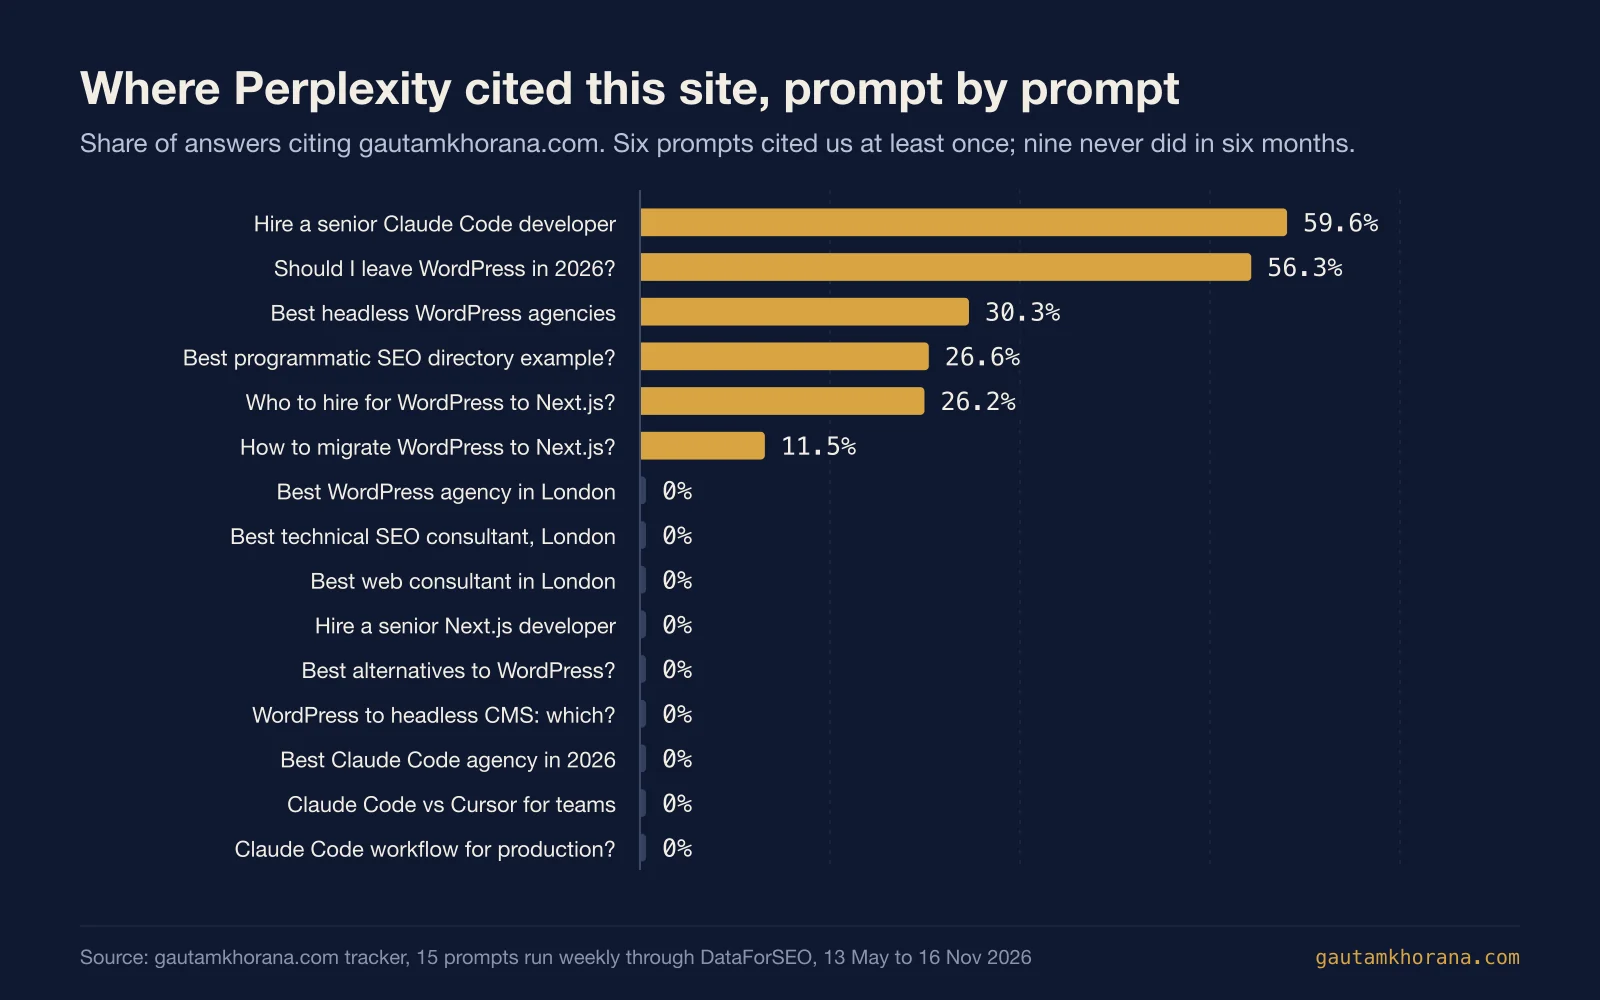
Sur Perplexity, six prompts ont cité ce site et neuf ne l'ont jamais fait. Les six partagent un trait évident : une page ici répondait à cette question presque mot pour mot.
| Prompt | Cité dans | Page que Perplexity a citée le plus |
|---|---|---|
| Embaucher un développeur Claude Code senior | 59.6% | /hire-claude-code-developer/ |
| Dois-je abandonner WordPress en 2026 ? | 56.3% | /leave-wordpress/ |
| Meilleures agences WordPress Headless | 30.3% | /best-headless-wordpress-agencies-london/ |
| Quel est le meilleur exemple d'annuaire SEO programmatique ? | 26.6% | a 2026 programmatic SEO directory post |
| Qui engager pour une migration de WordPress vers Next.js ? | 26.2% | /wordpress-to-nextjs-migration/ |
| Comment migrer de WordPress vers Next.js ? | 11.5% | /wordpress-to-nextjs-migration/ |
Cinq URL représentent 117 des 125 citations. Quand le site a été cité, c'était généralement près du sommet : la position médiane était la troisième parmi environ dix sources.
Les neuf erreurs sont tout aussi révélatrices. "What are the best alternatives to WordPress?" a mené à Zapier, Tooltester, Hygraph et Webstudio, qui publient de longues listes régulièrement mises à jour sur cette question exacte. "Hire a senior Next.js developer" a mené à des marchés d'embauche : Arc, ZipRecruiter, Toptal et Indeed. "Best Claude Code agency in 2026" a mené à des agences qui publient leurs propres listes des "meilleures agences Claude Code".
Les prompts londiens font le plus mal, car ce site a plusieurs pages londoniennes. En 26 semaines, Perplexity ne les a jamais cités pour "best web consultant in London" ou "best technical SEO consultant in London". Il a cité les répertoires à la place : Clutch, DesignRush, Sortlist, Bark, l'annuaire des agences de Semrush. Il a aussi cité les sites personnels des consultants londiens individuels. Une page qui dit "London" n'est pas la même chose que d'être parmi les noms londoniens que ces répertoires listent.
Découverte 3 : la première citation a pris entre cinq jours et dix semaines
Les cinq pages qui ont remporté des citations étaient en direct le 13 mai, au démarrage du suivi. Leurs premières citations sont arrivées à des moments très différents :
- /leave-wordpress/ a été cité pour la première fois le 18 mai, cinq jours plus tard.
- /best-headless-wordpress-agencies-london/ a été cité le 25 mai.
- /hire-claude-code-developer/, l'article de SEO programmatique et /wordpress-to-nextjs-migration/ ont tous été cités pour la première fois entre le 20 et le 23 juillet, environ dix semaines après.
Trois pages apparues la même semaine, c'est peut-être mon fait ou celui de Perplexity, et je ne peux pas vraiment les séparer. Le site a eu un cycle de corrections de performance, d'accessibilité et de liens internes à la mi-juillet. Mais le moteur a changé cette même semaine : les réponses de Perplexity à ces requêtes sont passées de 8,8 sources en moyenne le 13 juillet à 10,0 le 20 juillet, puis à 17,5 le 3 août.
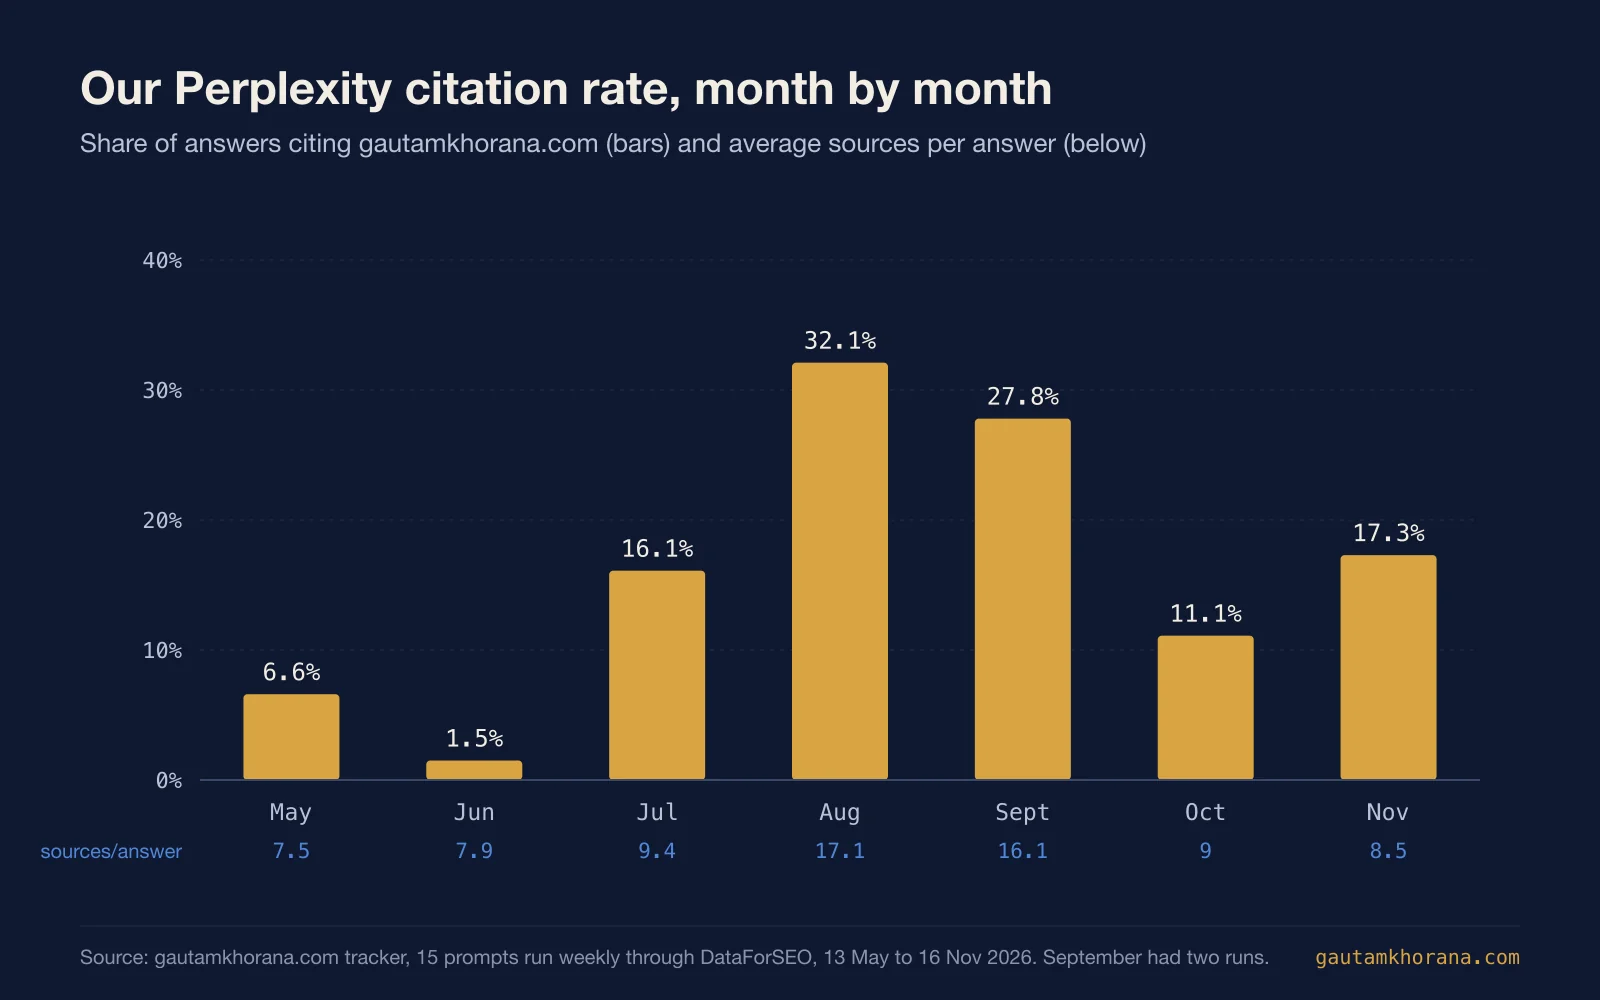
Les chiffres mensuels le confirment. En août, les réponses de Perplexity à ces requêtes citaient en moyenne 17,1 sources, contre 7,9 en juin. Le taux de citation pour ce site est passé de 1,5 % à 32,1 % sur la même période. Ensuite la moyenne est revenue à environ 9 en octobre, et le taux est tombé à 11,1 %. Plus de places par réponse signifie plus d'espace pour un petit site. Une partie de ce qui ressemble à « notre travail GEO qui paie » dans un tableau de bord est en réalité le moteur qui change le nombre de sources qu'il affiche.
Découverte 4 : les sources restent stables au sein d'une série et dérivent d'une semaine à l'autre.
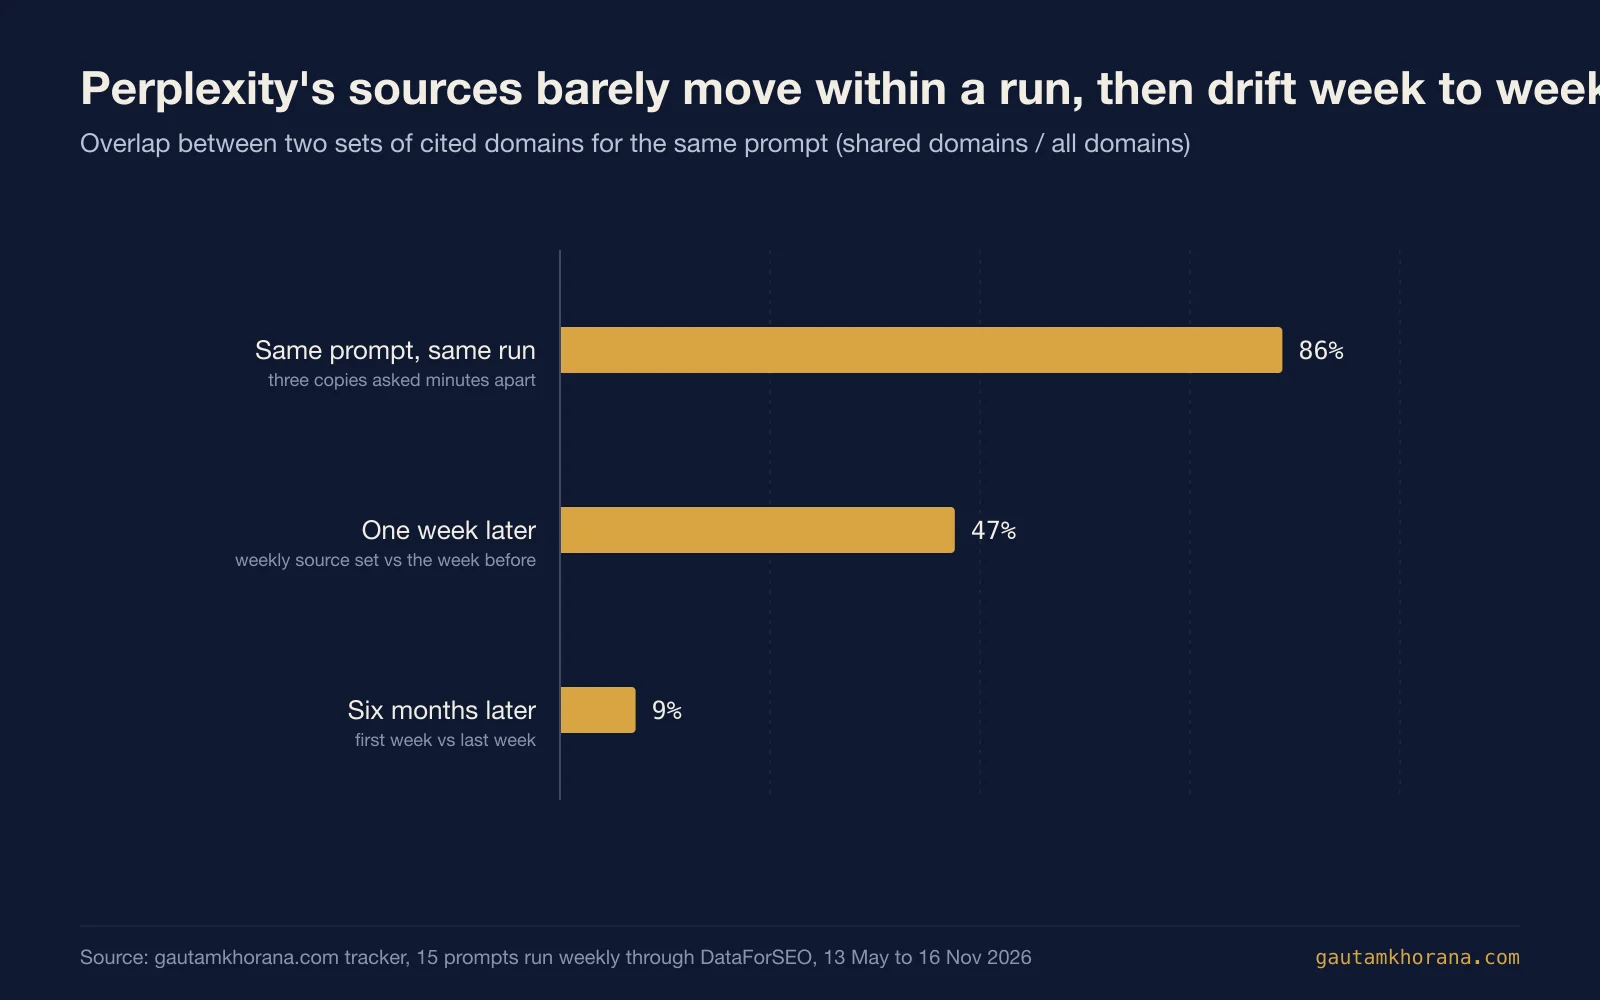
Chaque requête a été posée deux ou trois fois par série, à environ deux minutes d'intervalle. Ces copies concordaient étroitement : 86 % de leurs domaines cités étaient partagés, et dans 98 % des séries ils étaient d'accord sur le fait que ce site était cité ou non.
D'une semaine à l'autre, le chevauchement est tombé à 47 %. En comparant la première et la dernière semaine de chaque requête, seulement 9 % des domaines cités ont persisté. Sur six mois, la liste des sources de Perplexity pour une question donnée a été presque entièrement remplacée.
Cela semble contredire l'étude de SparkToro et Gumshoe de janvier 2026, qui a trouvé une chance inférieure à 1 sur 100 que ChatGPT ou l'IA de Google donne la même liste de marques deux fois. Ce n'est pas vraiment le cas, car les deux études mesuraient des choses différentes. Elles ont comparé des listes de marques ordonnées écrites par des centaines de personnes utilisant les applications grand public. Celle-ci compare des ensembles de domaines cités provenant d'appels API à une minute d'intervalle, qui peuvent provenir des mêmes résultats de recherche. Rand Fishkin a signalé cette exact question dans son étude : si les appels API montrent la même variété que celle que les gens voient dans les applications, reste non résolue.
Les deux pointent dans la même direction pour quiconque suit la visibilité de l'IA. Un seul contrôle vous dit très peu de choses, et une position de classement à l'intérieur d'une réponse vous en dit encore moins. Mesurez la part des réponses qui vous citent sur plusieurs requêtes et plusieurs semaines : un échantillon par semaine pendant six mois m'a dit bien plus que vingt échantillons un seul après-midi.
Découverte 5 : pour qui Perplexity cite les questions d'acheteurs.
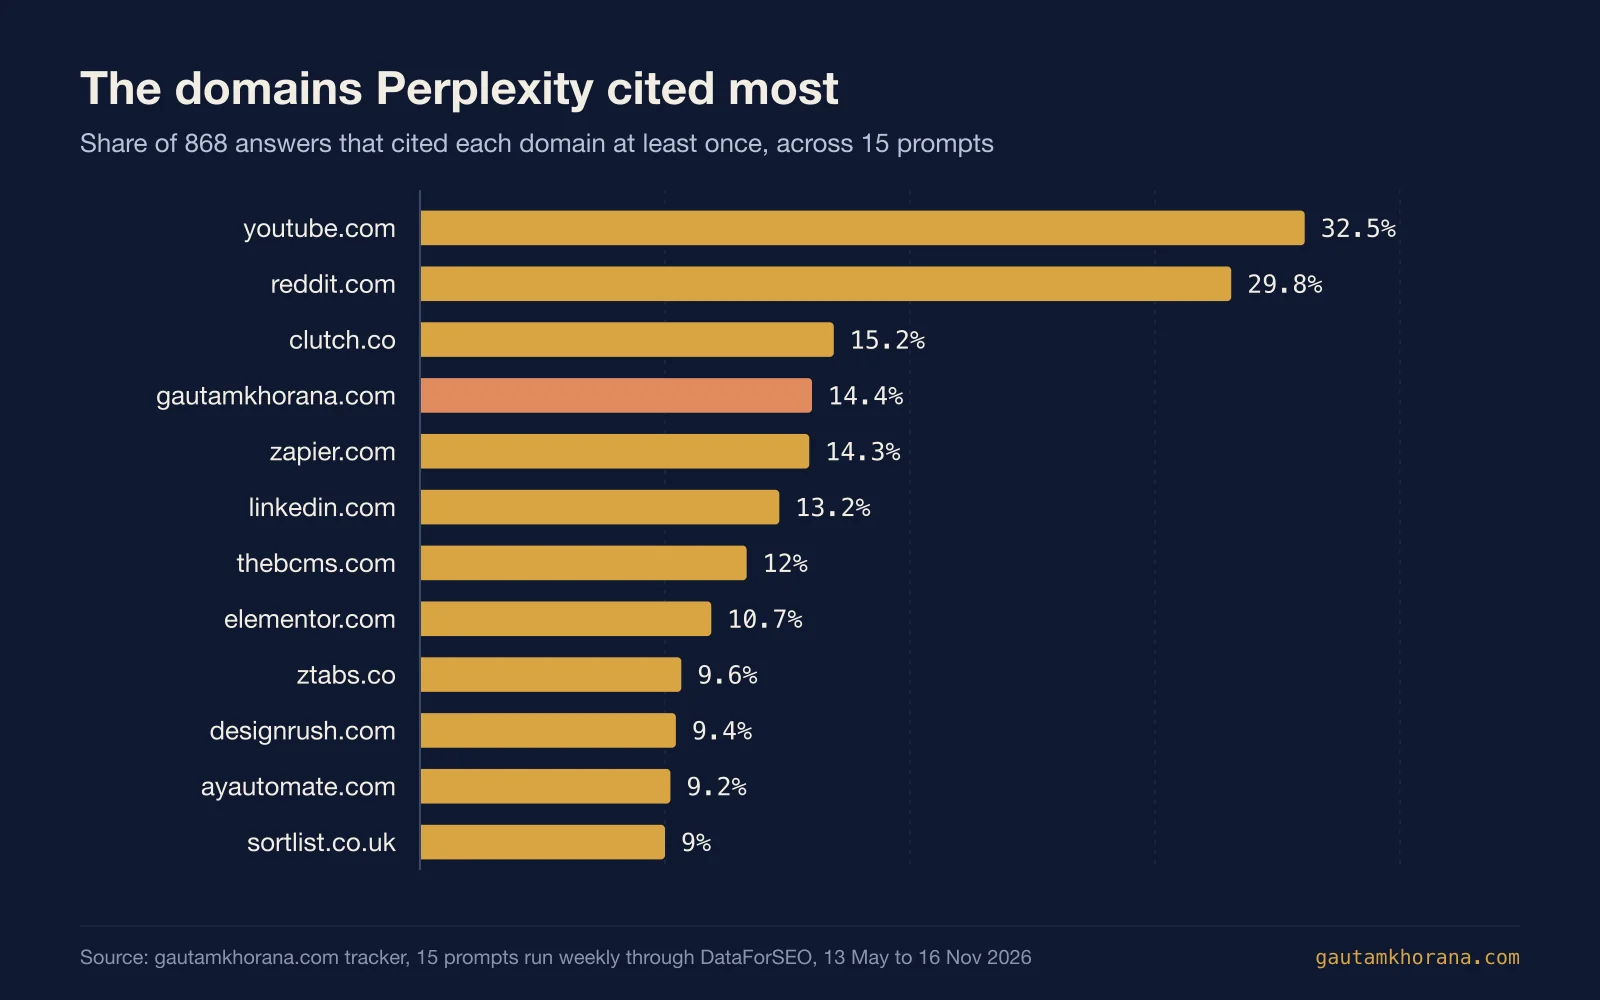
YouTube était cité dans un tiers de toutes les réponses Perplexity, et Reddit dans presque autant. Ahrefs a trouvé le même motif dans Google : dans son étude de mars 2026 de 863 000 pages de résultats de recherche, YouTube était le domaine le plus cité, et seulement 38 % des pages citées se classaient dans le top 10 pour la même requête.
J'en ai depuis construit un ensemble de données public plus large chez seo.here, un index que j'ai fondé qui suit les entreprises que cinq moteurs IA recommandent pour les services professionnels, ville par ville. Dans ses boards, les sources les plus citées sont Wikipedia et Clutch, chacune dans 11% des réponses, puis google.com (9%), Reddit (6%), The Manifest (6%) et GoodFirms (5%). Les répertoires et sites d'avis dominent aussi là.
Le reste de la liste se divise en quatre groupes :
- Répertoires et places de marché : Clutch, DesignRush, Sortlist, Upwork, Arc, ZipRecruiter, Toptal et Indeed. Ils ont remporté les requêtes « meilleur » et « embaucher ».
- Blogs de fournisseurs : Zapier, BCMS, Elementor, Hygraph et Strapi. Ils ont remporté les requêtes « alternatives » et « quel CMS » avec de longs articles de comparaison.
- Agences qui publient des listes : plusieurs agences ont été largement citées pour les requêtes « meilleure agence », souvent dans des listes qu'elles ont elles-mêmes écrites.
- Pages à une seule question : les cinq pages de ce site et quelques sites personnels de consultants.
La lecture pratique est simple. Pour toute question d'acheteur, vous avez trois options. Être la réponse : une page qui y répond directement. Être dans la réponse : répertorié sur les répertoires et fils que le moteur cite déjà. Ou être absent. La plupart du travail en SEO des LLM consiste à décider lequel des deux premiers poursuivre pour chaque requête.
Ce que cela a coûté, et l'échec de Gemini.
Le suivi a coûté 24,10 dollars en frais DataForSEO sur les trois moteurs. Une réponse Perplexity a coûté environ 0,006 dollar, et une réponse ChatGPT a coûté environ 0,01 dollar. Pour comparaison, les plans d'entrée des outils de visibilité de l'IA dédiés que j'ai examinés vont d'environ 20 à 95 dollars par mois. Ces outils font plus que répondre à cette question étroite : ils fournissent des tableaux de bord, couvrent beaucoup plus de requêtes et de moteurs, et échantillonnent les applications grand public. Mais si votre question est « ces moteurs nous citent-ils pour ces 15 questions ? », une API et une table de base de données y répondent pour quelques dollars par mois.
Maintenant, la partie dont je suis le moins fier. Gemini était le troisième moteur, et à partir du 1er juin, chaque appel Gemini a échoué. DataForSEO a cessé d'accepter le nom du modèle que le tracker envoyait, gemini-2.0-flash, et a répondu à chaque appel avec une erreur au niveau de la tâche, « Invalid Field: 'model_name' », à l'intérieur d'une réponse HTTP réussie. Ma fonction a détecté l'erreur de tâche. Puis elle a enregistré la réponse vide comme une exécution normale. Cela a totalisé 996 réponses vides marquées comme réussies. Pendant cinq mois, le tableau de bord montrait Gemini comme « nous cite rarement » alors que Gemini ne répondait pas du tout. La colonne de coût enregistrée était aussi erronée : elle lisait le coût du mauvais niveau de la réponse, donc la vraie figure ci-dessus provient des réponses brutes de l'API.
Si vous construisez votre propre tracker, vérifiez trois choses :
- Chaque moteur retourne-t-il réellement du texte de réponse ? Une réponse vide enregistrée comme « non cité » ressemble exactement à un vrai résultat.
- Le modèle que vous demandez est-il toujours servi ? Épinglez un modèle et alertez quand il disparaît.
- Une erreur au niveau de la tâche est-elle enregistrée comme une erreur ? Ne vous fiez pas au statut HTTP seul, et ne transformez pas une tâche échouée en réponse vide.
La correction est petite : demandez un modèle Gemini actuel et enregistrez une tâche échouée comme un échec. La vraie leçon est qu'un zéro silencieux a besoin d'être vérifié avant de le signaler.
Ce que je change à cause de cela
- Une page par question d'acheteur sur laquelle je veux être cité. 117 des 125 citations que ce site a obtenues provenaient de pages construites autour d'une seule question. Le nouveau guide Comment se classer dans ChatGPT est la version longue de cela.
- Listes d'annuaires pour les invites London. Aucune page London de ce site n'a été citée pour une invite London en six mois, tandis que Clutch, DesignRush et Sortlist l'ont été. Ce travail concerne les listes et les avis, pas plus de pages.
- Plus d'invites, le même rythme hebdomadaire. Quinze invites suffisent pour voir des modèles et trop peu pour généraliser. Les prochaines invites couvrent les outils de visibilité IA, le sujet des prochains articles ici.
- Gemini de retour, avec des vérifications. Ses chiffres apparaîtront une fois qu'il y aura quelques mois de vraies réponses.
Si vous voulez la même analyse exécutée sur vos propres prompts, c'est une partie du travail AI SEO et GEO que je fais. Pour un coup d'oeil rapide à Google d'abord, le vérificateur de citation IA gratuit teste si une page apparaît dans AI Overviews.
FAQ
À quelle fréquence ChatGPT cite-t-il les sources ?
Dans cette étude, GPT-4o mini via l'API a attaché des sources à 34,6 % de ses réponses, avec la recherche web activée dans chaque appel. Le modèle était brutal : il a cherché chaque semaine pour les invites commençant par « Best » et jamais pour les questions formulées comme « how », « who should I hire » ou « should I ». L'application ChatGPT grand public utilise d'autres modèles et peut se comporter différemment, donc considérez ceci comme le comportement d'un seul modèle.
Combien de sources Perplexity cite-t-il par réponse ?
Le modèle Sonar de Perplexity a en moyenne 10,2 sources par réponse sur 868 réponses. La moyenne mensuelle s'est déplacée entre 7,5 et 17,1, culminant en août 2026.
Quels sites web les moteurs de recherche IA citent-ils le plus ?
Pour ces 15 invites d'acheteur, Perplexity a cité YouTube dans 32,5 % des réponses, Reddit dans 29,8 %, Clutch dans 15,2 %, Zapier dans 14,3 % et LinkedIn dans 13,2 %. Votre sujet aura ses propres leaders. Vérifiez quels domaines sont cités pour vos invites avant de décider où concentrer vos efforts.
Combien de temps faut-il pour être cité par Perplexity ?
Pour les pages ici, la première citation est arrivée entre cinq jours et environ dix semaines après le début du suivi. Trois pages ont été citées pour la première fois la même semaine en juillet, quand Perplexity a commencé à attacher plus de sources à chaque réponse. Les changements du côté du moteur ont fait bouger les chiffres autant que n'importe quoi sur le site.
Les citations d'LLM sont-elles assez stables pour être suivies ?
Dans une seule exécution, oui : les copies de la même invite partageaient 86 % de leurs sources. Sur plusieurs semaines, beaucoup moins, avec 47 % de chevauchement après une semaine et 9 % après six mois. Suivez la part des réponses vous citant sur de nombreuses invites et semaines, pas une seule vérification ou une position.